 Lirafy
在手機上離線跑 Whisper:Wendo 的語音輸入怎麼做
可以,Whisper 能在手機上離線執行。靠 whisper.cpp 和一個下載過一次的 ggml 模型,手機自己就能把語音轉成文字,音訊不會離開裝置。Wendo 的語音輸入就是這樣做的。Wendo 是我們的 SSH 用戶端,用來在 iOS 和 Android 上追蹤 Claude Code 這類代理。以下說明它的做法:提供哪些模型、怎麼下載、用什麼格式錄音、怎麼處理 Whisper 回傳的內容,以及為什麼也保留了用你自己的金鑰呼叫 OpenAI 或 Groq API 的選項。
Whisper 可以在手機上離線使用:我們為什麼選它
用手機鍵盤打字給程式碼代理很慢。給 Claude Code 的指示通常是長句子(「查一下登入測試為什麼失敗,不要動那個 migration」),用大拇指一個字一個字打,正是最讓人懶得做的部分。用講的快多了。
問題在於你講的內容。對代理口述時,你會講到檔案、路徑、分支,有時還有客戶的東西。把這段音訊送到別人的伺服器上轉成文字,不見得讓人放心,訊號差的時候甚至根本不能用。所以 Wendo 預設的引擎是本機的 Whisper。在 lib/core/settings.dart 裡,初始值是 speechEngine = 'whisper',模型是 base,設定畫面用一句話交代這件事:「Whisper 使用 whisper.cpp 在手機上轉錄:不會向任何伺服器傳送音訊。」
在 Flutter 裡使用 whisper.cpp:whisper_ggml 和 record
whisper.cpp 是 OpenAI 語音辨識模型 Whisper 的 C/C++ 重新實作,使用 ggml 格式的權重。它在 CPU 上執行,沒有笨重的相依套件,儲存庫裡還附有 iOS 和 Android 的官方範例。在 Flutter 裡不必自己手寫綁定:pub.dev 上有好幾個包裝它的套件。
依照 pubspec.yaml,Wendo 用了兩個:
record: ^7.1.2
whisper_ggml: ^2.8.1
record 負責錄麥克風,whisper_ggml 負責呼叫 whisper.cpp。
有個細節第一眼看不出來。whisper_ggml 會用 ffmpeg 轉換輸入的音訊,而只為了這件事把 ffmpeg 放進手機 App,等於扛著一個很大的相依套件。既然 Wendo 本來就用 whisper.cpp 要的格式錄音,pubspec.yaml 就用一個本機的 stub 取代那個套件:
dependency_overrides:
  # whisper_ggml 用 ffmpeg 轉換音訊;Wendo 本來就錄 16 kHz 單聲道 WAV(見該套件)。
  ffmpeg_kit_flutter_new_min:
    path: packages/ffmpeg_kit_stub
這個 stub(packages/ffmpeg_kit_stub/lib/ffmpeg_kit.dart)只實作了 execute,而且永遠「失敗」。遇到這個失敗,whisper_ggml 就直接轉錄原本的檔案。如果你在 Flutter 裡用這個套件做離線 Whisper,錄音又是自己用 16 kHz WAV 錄的,也能用同樣的方法甩掉 ffmpeg。
提供哪些 Whisper 模型,模型有多大
Wendo 的 App 本身不內建任何模型。它在「設定 › 語音」中提供七個,定義在 lib/core/dictation.dart 的 WHISPER_MODELS,分成兩組:
- 多語言:Tiny(75 MB)、Base(142 MB)、Small(466 MB)和 Turbo,也就是
large-v3-turbo(App 顯示為 1.6 GB)。 - 只有英文:
tiny.en、base.en和small.en,大小和對應的多語言版本相同。
這些大小和 whisper.cpp 官方的模型表(ggml-org 儲存庫裡的 models/README.md)一致,表上寫的是 75 MiB、142 MiB、466 MiB,large-v3-turbo 則是 1.5 GiB。Turbo 的差異只是單位:1.5 GiB 大約是 1.6 GB。
whisper.cpp 的主要 README 也列出各尺寸大概會用掉多少記憶體:tiny 約 273 MB,base 約 388 MB,small 約 852 MB。在電腦上無所謂。但手機上同時還開著一個 SSH 工作階段、一個終端機,也許再加一個瀏覽器,就感覺得出來。
手機上該用哪個 Whisper 模型
App 自己的說明就講得很清楚:Tiny 是「最快,準確度較低」,Base 是「較快,準確度良好」,Small 是「較慢,準確度出色」,Turbo 則是「最高準確度」。對代理口述的話,base 是不錯的起點,這也是它成為預設值的原因。
.en 模型只聽得懂英文。Wendo 在程式碼裡強制這一點,所以語言設定對它們沒有作用:
// 「.en」模型只聽得懂英文。
final language = whisperModel.endsWith('.en') ? 'en' : settings.whisperLanguage;
如果你一律用英文口述,它們很值得:OpenAI 的 Whisper 儲存庫指出,.en 版本在英文上表現更好,tiny 和 base 尺寸尤其明顯。如果你會混用語言,例如講中文卻夾著英文函式名稱,就用多語言模型並固定語言。自動偵測(auto)是預設值,但只有三個字的口述,Whisper 能拿來猜語言的音訊太少,固定下來就少了這層不確定。
在你自己的手機上量延遲
我們不公布轉錄時間,因為那取決於手機、模型和你講了多久。Wendo 的做法是讓你自己量。「設定 › 語音」裡有一個麥克風按鈕可以試用引擎,辨識出的文字下方會出現一行資訊:引擎、模型、語言、格式、音訊長度,以及以毫秒計的延遲。這些來自 TranscriptionResult,每次轉錄都會記下 durationMs 和 latencyMs。用同一句話分別試 base 和 small,依你自己的數字決定。
模型怎麼下載
模型來自 Hugging Face 上的 whisper.cpp 儲存庫,使用標準檔名:
const _hf = 'https://huggingface.co/ggerganov/whisper.cpp/resolve/main';
String _fileName(String id) => 'ggml-$id.bin';點選一個還沒有的模型時,downloadModel 會先把它下載到暫存資料夾中的 .part 檔,下載完再移到 App 的文件資料夾。如果兩個資料夾在不同的磁碟區、無法重新命名,就複製過去再刪掉暫存檔。這樣一來,中斷的下載永遠不會被當成有效的模型。
即使如此,模型還是有可能損壞。當 whisper.cpp 回應「failed to load the model」時,Wendo 不會把原始錯誤丟給你,而是告訴你模型已損壞,請你在「設定 › 語音」中刪掉它再重新下載。
用 whisper.cpp 要的格式錄音
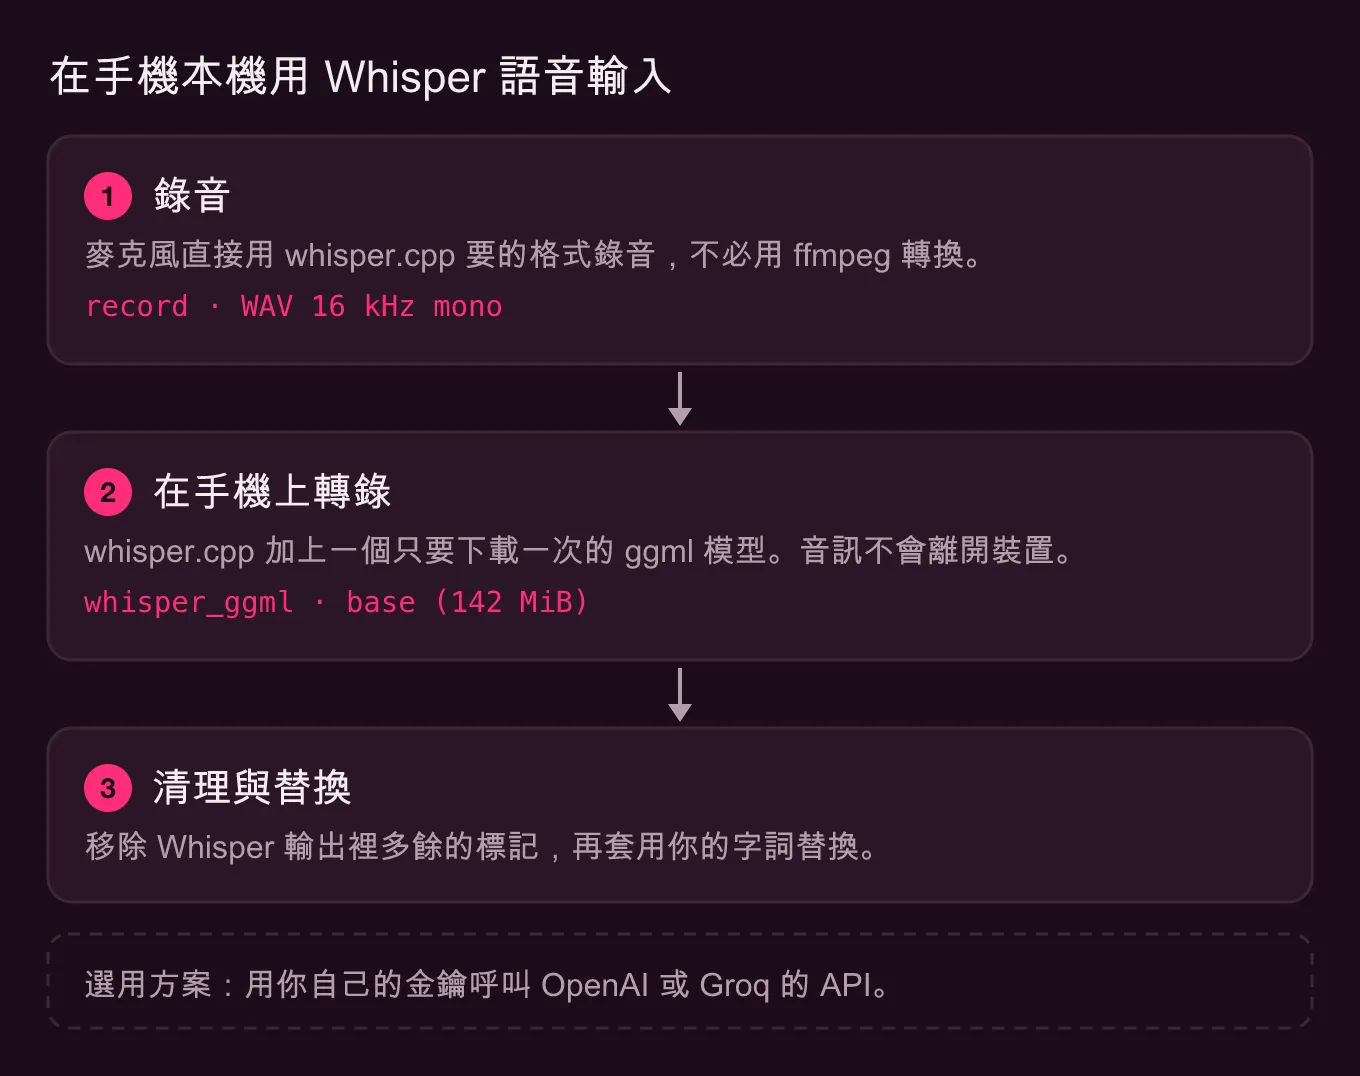
whisper.cpp 處理的是 16 位元、16 kHz、單聲道的 PCM WAV;它的 README 甚至附上轉成這個格式的 ffmpeg 指令。Wendo 直接用 record 照這個格式錄:
const RecordConfig(
  encoder: AudioEncoder.pcm16bits,
  sampleRate: _sampleRate, // 16000
  numChannels: 1,
  androidConfig: AndroidRecordConfig(audioSource: AndroidAudioSource.voiceRecognition),
)
在 Android 上,它要求 VOICE_RECOGNITION 音源,這是專為語音辨識設計的。你講話時,PCM 片段會累積在記憶體中。停止錄音後,Wendo 會等 200 ms 讓最後一段進來,並捨棄短於 0.3 秒的錄音,那通常是不小心按到。接著它在前面加上 44 位元組的 RIFF 標頭(lib/components/settings/byok.dart 中的 encodeWav),把 dictation.wav 寫進快取,進行轉錄,最後在 finally 裡刪掉這個檔案,不論成功或失敗。
模型在兩次語音輸入之間會保持載入(keepModelLoaded: true),所以只有第一次要付出載入的成本。如果你換了模型,或刪掉正在使用的模型,Wendo 會先釋放 whisper 的 context。
清理 Whisper 回傳的內容
Whisper 回傳的不一定是你口述的文字。聽不到人聲時,它會寫出 [BLANK_AUDIO] 這類標記,或是「(silencio)」這種括號裡的句子。在編輯器裡無傷大雅;在終端機裡,它們會跑進代理的提示字元。_stripNonSpeech 會移除方括號裡的大寫內容,如果結果只剩一組括號或星號,就整個捨棄。
清理過的文字會送到編輯器或終端機。預設寫入時不按 Enter,讓你送出前先檢查,除非你開啟了自動傳送。每次語音輸入都會存進本機的歷史紀錄(在「設定 › 語音 › 語音輸入歷史」),可以從那裡再送一次。
字詞替換
沒有哪個小模型能聽對「tmux」、「kubectl」或你的專案名稱。這就是字詞替換的用途:一組組「Whisper 聽成的」 → 「你想講的」。實作只要幾行:
// 字詞替換:依序、不分大小寫、只套用啟用的。
String applyReplacements(String text) {
  var out = text;
  for (final replacement in getSettings().dictationReplacements) {
    if (!replacement.enabled || replacement.from.isEmpty) continue;
    out = out.replaceAllMapped(RegExp(RegExp.escape(replacement.from), caseSensitive: false), (_) => replacement.to);
  }
  return out;
}
替換會依序套用、不分大小寫,可以停用而不必刪除;如果目標是空的,這個字就會被刪掉。本機 Whisper 和雲端都一樣適用。對付你工作上的專有名詞,加一條替換比換成更大的模型划算。
另一個選擇:自備金鑰(OpenAI 或 Groq)
BYOK(「bring your own key」)引擎會用你的 API 金鑰,把同一個 WAV 上傳到雲端服務商。Wendo 支援兩家,定義在 BYOK_PROVIDERS:
- OpenAI,呼叫
/v1/audio/transcriptions,預設模型是gpt-4o-mini-transcribe。 - Groq,呼叫它相容 OpenAI 的端點,預設是
whisper-large-v3-turbo。
模型欄位可以編輯,所以你可以填入服務商支援的其他模型。金鑰存在裝置的鑰匙圈中,每家服務商一把,App 在同一個畫面上說明它「只會傳送到」你選的服務商。請求是一個 multipart,包含 file、model、response_format: json,如果你沒有保留自動偵測,還會帶上 language。
兩個選項都保留,是因為它們解決的是不同的事。本機 Whisper 私密、沒訊號也能用、每次語音輸入都不花錢,代價是佔用空間和記憶體,而且要看手機的效能。雲端不佔手機空間,還能用上手機裝不下的大模型,但音訊會離開裝置,需要網路,也要付費給服務商。Groq 提供的正是 Wendo 在本機也有的 large-v3-turbo,差別在於它是在自己的伺服器上跑,而不是在你的手機上。OpenAI 則多了自家的轉錄模型。
我們的建議:先用本機的 base 加上幾條替換。如果你很常語音輸入、手機跑大模型很吃力,又不在意音訊離開手機,再改用 BYOK。
試試看
語音輸入是 Wendo 的一部分,它還沒有上架商店。可以用終端機或編輯器工具列上的麥克風啟動,也可以長按鍵盤按鈕,這是預設的手勢。如果你的電腦還沒設定好、無法用手機和代理對話,先看如何用手機操作 Claude Code;想在你語音輸入時讓工作階段一直活著,請看程式碼代理最少需要的 tmux。