 Lirafy
スマホで Whisper をネットなしで使う: Wendo の音声入力の仕組み
はい、Whisper はインターネットなしでスマホ上で動きます。whisper.cpp と、一度だけダウンロードする ggml モデルがあれば、スマホが自分で音声を文字にし、音声は端末の外に出ません。Wendo の音声入力はこの方式です。Wendo は、Claude Code のようなエージェントを iOS と Android から見守るための、私たちの SSH クライアントです。ここでは、どのモデルを用意しているか、どうダウンロードするか、どんなフォーマットで録音するか、Whisper の出力をどう処理するか、そして自分のキーで OpenAI や Groq の API を使う選択肢をなぜ残しているのかを書きます。
Whisper をスマホでオフラインで使う理由
スマホのキーボードでコーディングエージェントに指示を書くのは遅いものです。Claude Code への指示は長い文になりがちで(「ログインのテストが落ちる原因を調べて、マイグレーションには触らないで」)、それを親指で打つのがいちばん面倒なところです。話すほうが速く済みます。
問題は話す内容です。エージェントに口述するときは、ファイル名、パス、ブランチ、ときには顧客に関わることまで口にします。その音声を文字起こしのために他人のサーバーへ送るのは気が進まないこともありますし、電波が弱ければそもそも動きません。だから Wendo の既定のエンジンはローカルの Whisper です。lib/core/settings.dart の初期値は speechEngine = 'whisper' でモデルは base、設定画面はこれを一行で説明しています。「Whisper は whisper.cpp を使ってスマートフォン上で文字起こしします。音声はどのサーバーにも送信されません。」
Flutter で whisper.cpp を使う: whisper_ggml と record
whisper.cpp は、OpenAI の音声認識モデル Whisper を C/C++ で再実装したもので、ggml 形式の重みを使います。重い依存なしに CPU で動き、リポジトリには iOS と Android の公式サンプルもあります。Flutter ではバインディングを手書きする必要はなく、pub.dev にラッパーのパッケージがいくつかあります。
pubspec.yaml を見ると、Wendo が使っているのは次の 2 つです。
record: ^7.1.2
whisper_ggml: ^2.8.1
record がマイクを録音し、whisper_ggml が whisper.cpp を呼び出します。
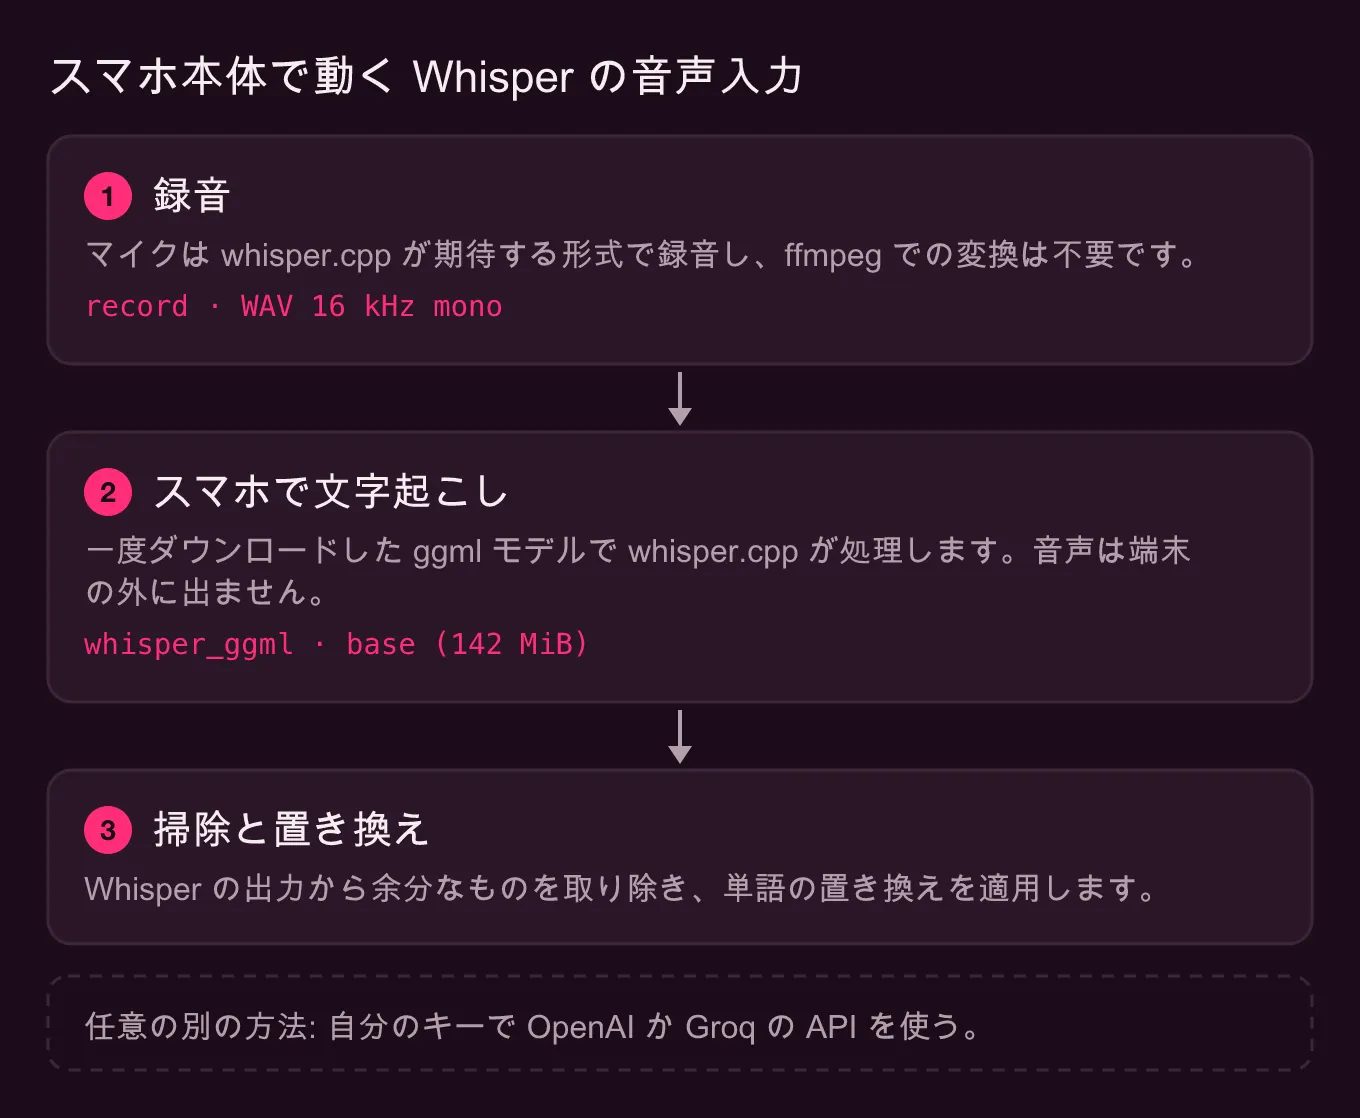
ぱっと見では分からない点がひとつあります。whisper_ggml は入力音声を ffmpeg で変換しますが、そのためだけにモバイルアプリへ ffmpeg を入れるのは大きな依存を抱えることになります。Wendo は最初から whisper.cpp が期待するフォーマットで録音しているので、pubspec.yaml でそのパッケージをローカルのスタブに差し替えています。
dependency_overrides:
  # whisper_ggml convierte el audio con ffmpeg; Wendo ya graba WAV de 16 kHz mono (ver el paquete).
  ffmpeg_kit_flutter_new_min:
path: packages/ffmpeg_kit_stubスタブ(packages/ffmpeg_kit_stub/lib/ffmpeg_kit.dart)は execute だけを実装していて、これは必ず「失敗」します。その失敗を受けて、whisper_ggml はファイルをそのまま文字起こしします。このパッケージで Flutter のオフライン Whisper を組んでいて、録音を自分で 16 kHz の WAV にしているなら、同じやり方で ffmpeg を外せます。
用意している Whisper のモデルとサイズ
Wendo はアプリ本体にモデルを同梱していません。「設定 › 音声」に 7 つのモデルがあり、lib/core/dictation.dart の WHISPER_MODELS で 2 つのグループに分けて定義しています。
- 多言語: Tiny(75 MB)、Base(142 MB)、Small(466 MB)、そして
large-v3-turboの Turbo(アプリでは 1.6 GB と表示)。 - 英語のみ:
tiny.en、base.en、small.en。サイズは多言語版と同じです。
これらのサイズは whisper.cpp の公式モデル表(ggml-org のリポジトリの models/README.md)と一致していて、そこでは 75 MiB、142 MiB、466 MiB、large-v3-turbo が 1.5 GiB となっています。Turbo の違いは単位だけで、1.5 GiB はおよそ 1.6 GB です。
whisper.cpp のメインの README には、サイズごとのおおよそのメモリ使用量も載っています。tiny が約 273 MB、base が 388 MB、small が 852 MB です。パソコンなら気になりません。SSH セッションとターミナルと、場合によってはブラウザも開いているスマホでは、効いてきます。
スマホで使う Whisper のモデルの選び方
アプリ内の説明がよくまとまっています。Tiny は「最速、精度は低め」、Base は「高速、精度は良好」、Small は「やや低速、精度は高い」、Turbo は「最高精度」です。エージェントへの口述なら base が出発点としてちょうどよく、だから既定値にしています。
.en のモデルは英語しか理解しません。Wendo はこれをコードで強制しているので、言語の設定は効きません。
// Los modelos «.en» solo entienden inglés.
final language = whisperModel.endsWith('.en') ? 'en' : settings.whisperLanguage;
いつも英語で話すなら .en を選ぶ価値があります。OpenAI の Whisper リポジトリによると、.en 版は英語でより良い結果を出し、特に tiny と base でその差が大きいそうです。複数の言語を混ぜる場合や、日本語で話しながら関数名だけ英語で言う場合は、多言語モデルで言語を固定してください。既定は自動検出(auto)ですが、3 語ほどの短い口述では言語を当てるための音声が少なすぎます。言語を固定すれば、その心配がなくなります。
レイテンシは自分のスマホで測る
文字起こしにかかる時間は公開していません。スマホ、モデル、話す長さで変わるからです。その代わり、Wendo では自分で測れるようにしています。「設定 › 音声」にエンジンを試すマイクボタンがあり、認識されたテキストの下に、エンジン、モデル、言語、フォーマット、音声の長さ、ミリ秒単位のレイテンシを並べた行が出ます。これは各文字起こしの durationMs と latencyMs を持つ TranscriptionResult から来ています。同じ文で base と small を試し、自分の数字で決めてください。
モデルのダウンロード
モデルは Hugging Face にある whisper.cpp のリポジトリから、標準のファイル名で取得します。
const _hf = 'https://huggingface.co/ggerganov/whisper.cpp/resolve/main';
String _fileName(String id) => 'ggml-$id.bin';まだ持っていないモデルをタップすると、downloadModel はまず一時フォルダの .part ファイルにダウンロードし、終わってからアプリのドキュメントフォルダに移します。2 つのフォルダが別のボリュームにあって名前を変えられない場合は、コピーしてから一時ファイルを消します。途中で切れたダウンロードが、正しいモデルとして扱われることはありません。
それでもモデルが壊れることはあります。whisper.cpp が「failed to load the model」を返したとき、Wendo は生のエラーを見せず、モデルが壊れていることを伝えて、「設定 › 音声」で削除してダウンロードし直すよう案内します。
whisper.cpp が期待するフォーマットで録音する
whisper.cpp が扱うのは 16 ビット PCM、16 kHz、モノラルの WAV で、README にはそのフォーマットに変換する ffmpeg コマンドまで載っています。Wendo は record を使って最初からその形式で録音します。
const RecordConfig(
  encoder: AudioEncoder.pcm16bits,
  sampleRate: _sampleRate, // 16000
  numChannels: 1,
  androidConfig: AndroidRecordConfig(audioSource: AndroidAudioSource.voiceRecognition),
)
Android では、音声認識向けの VOICE_RECOGNITION ソースを指定します。話している間、PCM のチャンクはメモリにたまっていきます。止めると、Wendo は最後のチャンクが届くまで 200 ms 待ち、0.3 秒未満の録音は誤タップとみなして捨てます。そのあと 44 バイトの RIFF ヘッダーを先頭に付け(lib/components/settings/byok.dart の encodeWav)、キャッシュに dictation.wav を書き出し、文字起こしして、成功しても失敗しても finally でファイルを消します。
モデルは口述と口述の間も読み込んだままにしておく(keepModelLoaded: true)ので、読み込みのコストを払うのは最初の 1 回だけです。モデルを切り替えたときや使用中のモデルを削除したときは、先に whisper のコンテキストを解放します。
Whisper の出力を掃除する
Whisper がいつも口述した文を返すとは限りません。声が聞こえないときは [BLANK_AUDIO] のような印や、「(沈黙)」のような括弧書きを出力します。エディターなら害はありませんが、ターミナルではエージェントのプロンプトに入ってしまいます。_stripNonSpeech は大文字の角括弧で囲まれた部分を取り除き、結果が括弧書きやアスタリスクだけなら丸ごと捨てます。
掃除したテキストはコンポーザーかターミナルに入ります。既定では Enter を押さずに入力するので、送る前に確認できます。自動送信をオンにした場合は別です。口述した内容はすべてローカルの履歴(「設定 › 音声 › 音声入力履歴」)に残り、そこから再送できます。
単語の置き換え
小さなモデルは「tmux」や「kubectl」、自分のプロジェクト名をまず正しく聞き取れません。そのための単語の置き換えです。「Whisper が聞き取ったもの」→「本当に言いたかったもの」の組を登録します。実装は数行に収まります。
// Reemplazos de palabras: en orden, sin distinguir mayúsculas, solo los activos.
String applyReplacements(String text) {
  var out = text;
  for (final replacement in getSettings().dictationReplacements) {
    if (!replacement.enabled || replacement.from.isEmpty) continue;
    out = out.replaceAllMapped(RegExp(RegExp.escape(replacement.from), caseSensitive: false), (_) => replacement.to);
  }
  return out;
}
置き換えは順番に、大文字と小文字を区別せずに適用されます。削除せずに無効にでき、置き換え先が空なら単語が消えます。ローカルの Whisper でもクラウドでも同じように効きます。仕事で使う固有名詞なら、大きなモデルに乗り換えるより置き換えを登録するほうが安上がりです。
もうひとつの選択肢: 自分のキーを使う(OpenAI か Groq)
BYOK(「bring your own key」)エンジンは、同じ WAV をあなたの API キーでクラウドのプロバイダーに送ります。Wendo が対応しているのは BYOK_PROVIDERS に定義した 2 つです。
- OpenAI。
/v1/audio/transcriptionsに送り、既定のモデルはgpt-4o-mini-transcribe。 - Groq。OpenAI 互換のエンドポイントに送り、既定は
whisper-large-v3-turbo。
モデルの欄は編集できるので、プロバイダーが対応している別のモデルも指定できます。キーはプロバイダーごとに端末のキーチェーンに保存され、同じ画面に、選んだプロバイダーに「のみ送信されます」と表示されます。リクエストは file、model、response_format: json、それに自動検出のままでなければ language を含む multipart です。
2 つの選択肢があるのは、解決するものが違うからです。ローカルの Whisper はプライベートで、電波がなくても動き、口述ごとの費用もかかりません。その代わり容量とメモリを使い、スマホの性能に左右されます。クラウドはスマホの容量を使わず、スマホには載らない大きなモデルを使えますが、音声は端末の外に出て、接続が必要で、プロバイダーに料金を払います。Groq が動かすのは Wendo がローカルで提供しているのと同じ large-v3-turbo で、違いはあなたのスマホではなく Groq のサーバーで動くことです。OpenAI は独自の文字起こしモデルを提供しています。
私たちのおすすめは、ローカルの base といくつかの置き換えから始めることです。たくさん口述する、スマホが大きなモデルでは苦しい、音声が端末の外に出ても構わない、という条件がそろったら BYOK に移ってください。
試してみる
音声入力は Wendo の一部で、Wendo はまだストアに出ていません。ターミナルかコンポーザーのバーにあるマイクから、または既定のジェスチャーであるキーボードボタンの長押しで起動します。スマホからエージェントと話せるようにパソコンをまだ準備していないなら、スマホから Claude Code を使う方法から始めてください。口述している間もセッションを生かしておくには、コーディングエージェントのための tmux が役に立ちます。