 Lirafy
在手机上离线运行 Whisper:Wendo 的语音输入是怎么做的
可以,Whisper 能在手机上离线运行。用 whisper.cpp 加一个下载过一次的 ggml 模型,手机自己就能把语音转成文字,音频不会离开设备。Wendo 的听写就是这样做的。Wendo 是我们的 SSH 客户端,用来在 iOS 和 Android 上跟进 Claude Code 这类代理。下面讲它的实现:提供哪些模型、怎么下载、用什么格式录音、怎么处理 Whisper 返回的内容,以及为什么还保留了用你自己的密钥调用 OpenAI 或 Groq API 的选项。
Whisper 能在手机上离线使用:我们为什么选它
用手机键盘给代码代理打字很慢。给 Claude Code 的指令往往是长句子(“查一下登录测试为什么失败,别动那个迁移”),用拇指一个个敲出来正是最让人犯懒的那一步。说话要快得多。
问题在于你说的内容。给代理口述时,你会提到文件、路径、分支,有时还有客户的东西。把这段音频发到别人的服务器上转文字,并不总是让人放心,信号差的时候干脆用不了。所以 Wendo 默认的引擎是本地 Whisper。在 lib/core/settings.dart 里,初始值是 speechEngine = 'whisper',模型为 base,设置页面用一句话概括了这一点:“Whisper 使用 whisper.cpp 在手机上转写:不会向任何服务器发送音频。”
在 Flutter 里用 whisper.cpp:whisper_ggml 和 record
whisper.cpp 是 OpenAI 语音识别模型 Whisper 的 C/C++ 重新实现,使用 ggml 格式的权重。它在 CPU 上运行,没有沉重的依赖,仓库里还带有 iOS 和 Android 的官方示例。在 Flutter 里不用手写绑定:pub.dev 上有好几个封装它的包。
根据 pubspec.yaml,Wendo 用了两个:
record: ^7.1.2
whisper_ggml: ^2.8.1
record 负责录制麦克风,whisper_ggml 负责调用 whisper.cpp。
有个细节第一眼看不出来。whisper_ggml 用 ffmpeg 转换输入音频,而只为这件事把 ffmpeg 塞进手机应用,等于背上一个很大的依赖。既然 Wendo 本来就按 whisper.cpp 期望的格式录音,pubspec.yaml 就用一个本地桩替换了那个包:
dependency_overrides:
  # whisper_ggml 用 ffmpeg 转换音频;Wendo 本来就录 16 kHz 单声道 WAV(见该包)。
  ffmpeg_kit_flutter_new_min:
path: packages/ffmpeg_kit_stub这个桩(packages/ffmpeg_kit_stub/lib/ffmpeg_kit.dart)只实现了 execute,而且总是“失败”。遇到这个失败,whisper_ggml 就直接转写原文件。如果你在 Flutter 里用这个包做离线 Whisper,录音又是自己按 16 kHz WAV 录的,也可以用同样的办法甩掉 ffmpeg。
提供哪些 Whisper 模型,模型有多大
Wendo 应用本身不带任何模型。它在“设置 › 语音”里提供七个,定义在 lib/core/dictation.dart 的 WHISPER_MODELS 中,分为两组:
- 多语言:Tiny(75 MB)、Base(142 MB)、Small(466 MB)和 Turbo,也就是
large-v3-turbo(应用里显示为 1.6 GB)。 - 仅英语:
tiny.en、base.en和small.en,大小与对应的多语言版本相同。
这些大小和 whisper.cpp 官方的模型表(ggml-org 仓库里的 models/README.md)一致,那张表给出的是 75 MiB、142 MiB、466 MiB,large-v3-turbo 为 1.5 GiB。Turbo 的差别只是单位不同:1.5 GiB 大约等于 1.6 GB。
whisper.cpp 的主 README 还列出了各个尺寸大致占用的内存:tiny 约 273 MB,base 约 388 MB,small 约 852 MB。在电脑上这无所谓。可手机上同时还开着一个 SSH 会话、一个终端,也许还有一个浏览器,就能感觉到了。
手机上该用哪个 Whisper 模型
应用自己的说明已经概括了:Tiny 是“最快,准确度较低”,Base 是“较快,准确度良好”,Small 是“较慢,准确度出色”,Turbo 则是“最高准确度”。给代理口述的话,base 是不错的起点,这也是它成为默认值的原因。
.en 模型只懂英语。Wendo 在代码里强制这一点,所以语言设置对它们不起作用:
// “.en” 模型只懂英语。
final language = whisperModel.endsWith('.en') ? 'en' : settings.whisperLanguage;
如果你总是用英语口述,它们值得用:OpenAI 的 Whisper 仓库指出,.en 版本在英语上表现更好,tiny 和 base 尺寸尤其明显。如果你混着说几种语言,比如说中文却夹着英文函数名,就用多语言模型并固定语言。自动检测(auto)是默认值,但只有三个词的口述,Whisper 能拿来猜语言的音频太少,固定下来就省掉了这个不确定。
在你自己的手机上测延迟
我们不公布转写耗时,因为它取决于手机、模型和你说了多久。Wendo 的做法是让你自己测。在“设置 › 语音”里有一个麦克风按钮,用来试用引擎,识别出的文字下方会显示一行信息:引擎、模型、语言、格式、音频时长和以毫秒计的延迟。这些来自 TranscriptionResult,每次转写都会记录 durationMs 和 latencyMs。用同一句话分别试试 base 和 small,按你自己的数字来决定。
模型怎么下载
模型来自 Hugging Face 上的 whisper.cpp 仓库,使用标准文件名:
const _hf = 'https://huggingface.co/ggerganov/whisper.cpp/resolve/main';
String _fileName(String id) => 'ggml-$id.bin';点一个还没有的模型时,downloadModel 先把它下载到临时目录里的一个 .part 文件,下完后再移到应用的文档目录。如果两个目录在不同的卷上、无法重命名,就复制过去再删掉临时文件。这样,一次中断的下载永远不会被当成一个有效的模型。
即便如此,模型还是可能损坏。当 whisper.cpp 返回“failed to load the model”时,Wendo 不会把原始错误甩给你,而是提示模型已损坏,请你在“设置 › 语音”里删掉它再重新下载。
按 whisper.cpp 期望的格式录音
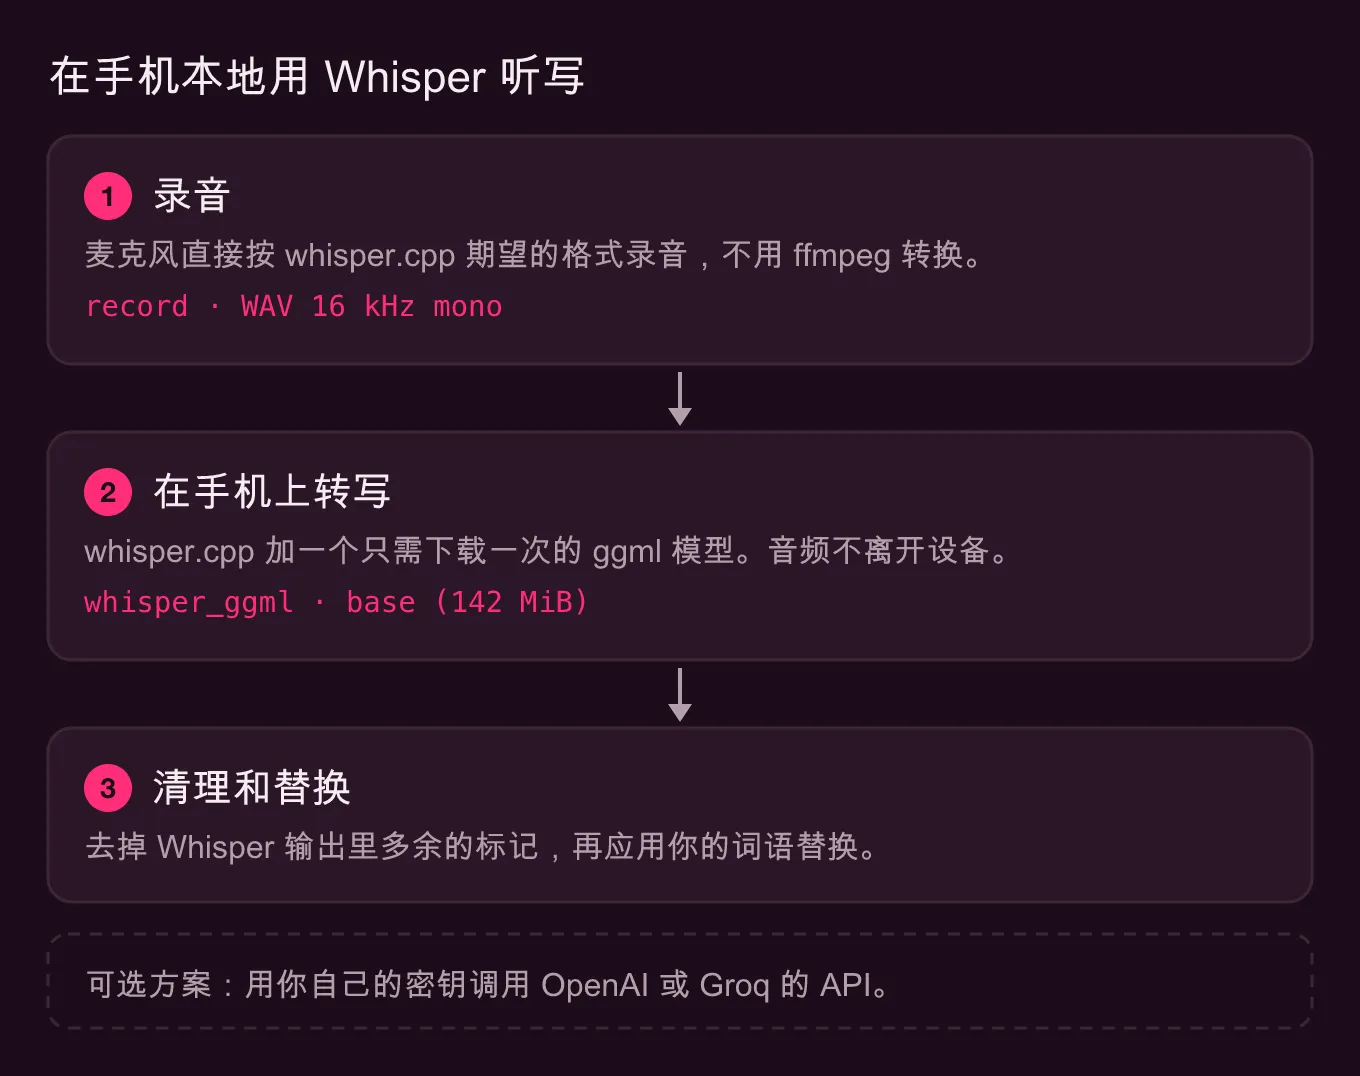
whisper.cpp 处理的是 16 位、16 kHz、单声道的 PCM WAV;它的 README 甚至给出了转换成这个格式的 ffmpeg 命令。Wendo 直接用 record 按这个格式录音:
const RecordConfig(
  encoder: AudioEncoder.pcm16bits,
  sampleRate: _sampleRate, // 16000
  numChannels: 1,
  androidConfig: AndroidRecordConfig(audioSource: AndroidAudioSource.voiceRecognition),
)
在 Android 上,它请求 VOICE_RECOGNITION 音源,这是专为语音识别设计的。你说话时,PCM 片段在内存里累积。停止录音后,Wendo 等 200 ms 让最后一段到达,并丢弃短于 0.3 秒的录音,那通常是误触。然后它在前面加上 44 字节的 RIFF 头(lib/components/settings/byok.dart 里的 encodeWav),把 dictation.wav 写进缓存,转写,最后在 finally 里删掉这个文件,不管成功与否。
模型在两次听写之间保持加载(keepModelLoaded: true),所以只有第一次要付出加载的代价。如果你换了模型或删掉正在使用的模型,Wendo 会先释放 whisper 的上下文。
清理 Whisper 返回的内容
Whisper 返回的并不总是口述的文字。听不到人声时,它会写出 [BLANK_AUDIO] 这样的标记,或者“(silencio)”之类括号里的短语。在编辑器里这无伤大雅;在终端里,它们会跑进代理的提示符。_stripNonSpeech 会去掉方括号里的大写内容,如果结果只剩一个括号或几个星号,就整个丢弃。
清理后的文字进入编辑器或终端。默认写入时不按回车,方便你发出去之前检查一遍,除非你打开了自动发送。每次听写都会存进本地历史(在“设置 › 语音 › 听写历史”里),可以从那里重新发送。
词语替换
没有哪个小模型能听对“tmux”“kubectl”或者你的项目名。这就是词语替换的用处:一对对“Whisper 听成的” → “你想说的”。实现只有几行:
// 词语替换:按顺序、不区分大小写、只用启用的。
String applyReplacements(String text) {
  var out = text;
  for (final replacement in getSettings().dictationReplacements) {
    if (!replacement.enabled || replacement.from.isEmpty) continue;
    out = out.replaceAllMapped(RegExp(RegExp.escape(replacement.from), caseSensitive: false), (_) => replacement.to);
  }
  return out;
}
替换按顺序执行、不区分大小写,可以停用而不删除;如果目标为空,这个词就被删掉。本地 Whisper 和云端都一样适用。对付你工作里的专有名词,加一条替换比换成更大的模型便宜。
另一个选择:自带密钥(OpenAI 或 Groq)
BYOK(“bring your own key”)引擎会用你的 API 密钥,把同一个 WAV 上传给云端服务商。Wendo 支持两家,定义在 BYOK_PROVIDERS 中:
- OpenAI,调用
/v1/audio/transcriptions,默认模型是gpt-4o-mini-transcribe。 - Groq,调用它兼容 OpenAI 的端点,默认是
whisper-large-v3-turbo。
模型字段可以编辑,所以你可以填服务商支持的其他模型。密钥存在设备的钥匙串里,每家服务商一个,应用在同一个页面上说明它“只会发送到”你选的服务商。请求是一个 multipart,包含 file、model、response_format: json,如果你没有保留自动检测,还会带上 language。
两个选项都在,是因为它们解决的是不同的问题。本地 Whisper 私密、没信号也能用、每次听写不花钱,代价是占空间和内存,并且取决于手机的性能。云端不占手机空间,还能用上手机装不下的大模型,但音频会离开设备,需要联网,还要付钱给服务商。Groq 提供的正是 Wendo 在本地也提供的 large-v3-turbo,区别是它在自己的服务器上跑,而不是在你的手机上。OpenAI 则多了它自家的转写模型。
我们的建议:先用本地的 base 加几条替换。如果你听写得很多,手机跑大模型吃力,又不介意音频离开手机,再换成 BYOK。
试一试
听写是 Wendo 的一部分,它还没有上架应用商店。可以用终端或编辑器工具栏上的麦克风启动,也可以长按键盘按钮,这是默认的手势。如果你的电脑还没配置好、没法用手机和代理对话,先看如何用手机使用 Claude Code;想在你听写时让会话一直活着,看代码代理最少需要的 tmux。