 Lirafy
Whisper på mobilen utan internet: så dikterar Wendo
Ja, Whisper fungerar på mobilen utan internet. Med whisper.cpp och en ggml-modell som laddas ned en gång transkriberar telefonen rösten på egen hand, och ljudet lämnar aldrig enheten. Så dikterar Wendo, vår SSH-klient för att följa agenter som Claude Code från iOS och Android. Här berättar vi hur det är byggt: vilka modeller som finns, hur de laddas ned, i vilket format appen spelar in, vad den gör med det Whisper returnerar och varför det också går att använda OpenAI:s eller Groqs API med din egen nyckel.
Whisper utan internet på mobilen: varför vi använder det
Att skriva till en kodagent med mobilens tangentbord går långsamt. Instruktionerna till Claude Code är oftast långa meningar (”kolla varför inloggningstestet fallerar och rör inte migreringen”), och att knappa in dem med tummen är just den del man inte orkar. Att prata går fortare.
Problemet är vad du säger. När du dikterar för en agent nämner du filer, sökvägar, grenar och ibland kundens saker. Att skicka det ljudet till någon annans server för att göra text av det känns inte alltid rätt, och med dålig täckning fungerar det inte ens. Därför är Wendos standardmotor lokal Whisper. I lib/core/settings.dart är startvärdet speechEngine = 'whisper' med modellen base, och inställningsskärmen sammanfattar det på en rad: ”Whisper transkriberar på telefonen med whisper.cpp: inget ljud skickas till någon server.”
whisper.cpp i Flutter: whisper_ggml och record
whisper.cpp är en omimplementering i C/C++ av Whisper, OpenAI:s modell för taligenkänning, och använder viktformatet ggml. Den kör på CPU utan tunga beroenden, och dess repo har officiella exempel för iOS och Android. I Flutter behöver du inte skriva bindningarna för hand: det finns flera paket på pub.dev som kapslar in den.
Wendo använder två, enligt sin pubspec.yaml:
record: ^7.1.2
whisper_ggml: ^2.8.1
record spelar in mikrofonen och whisper_ggml anropar whisper.cpp.
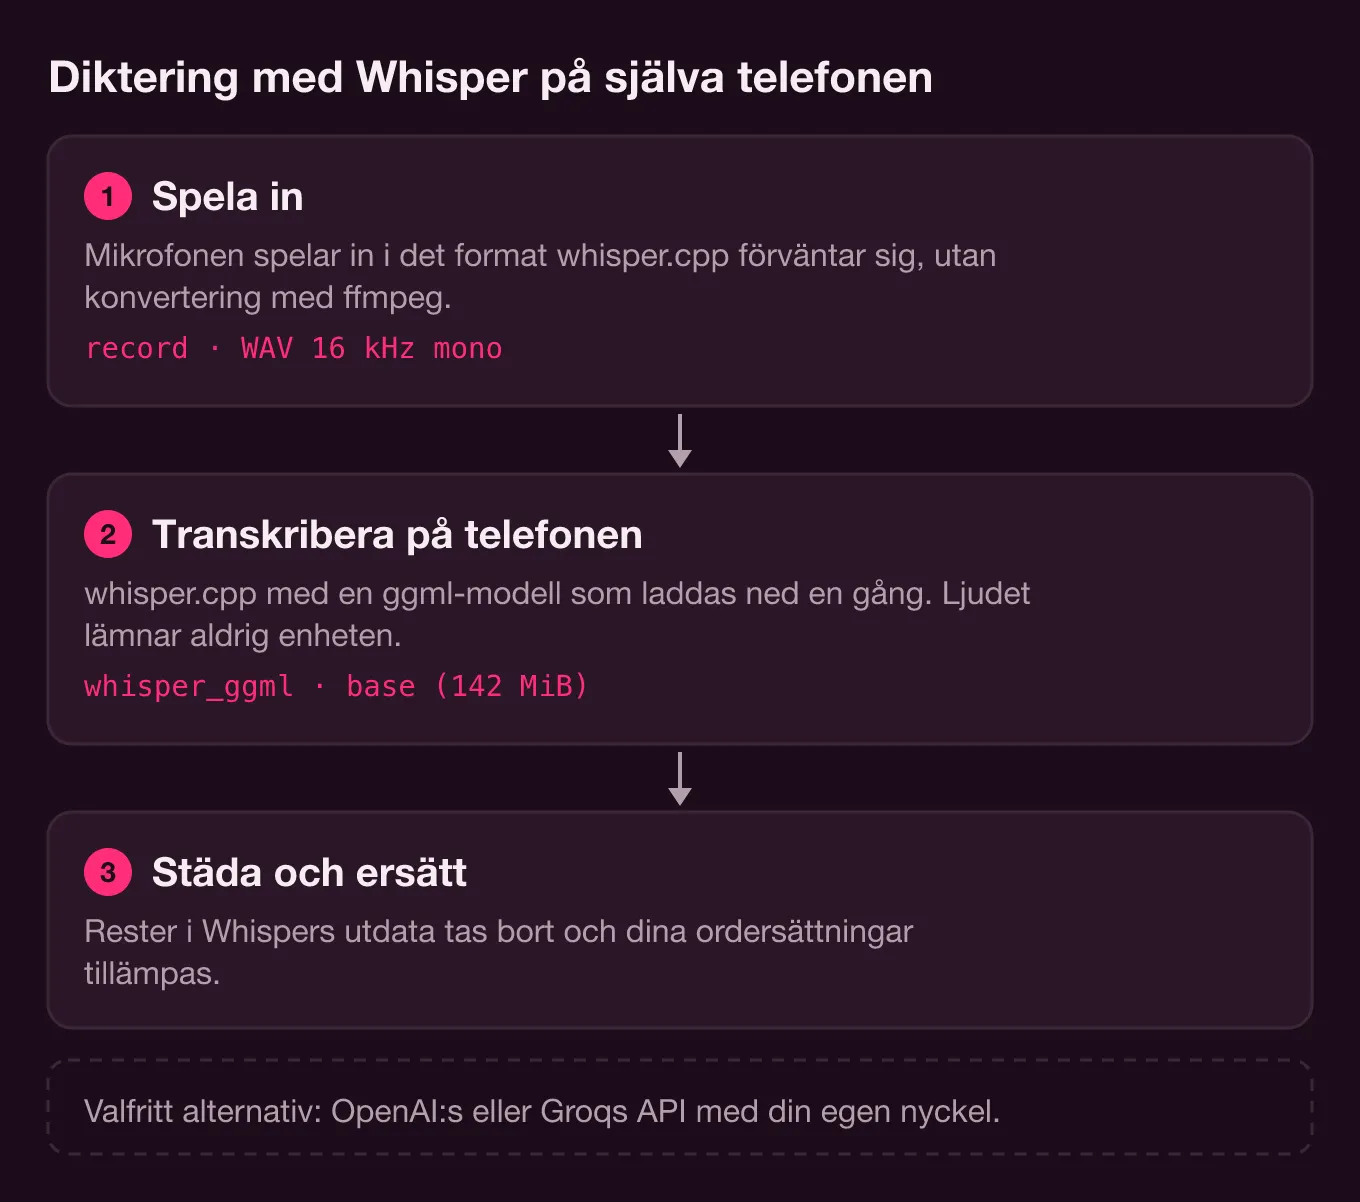
Det finns en detalj som inte syns direkt. whisper_ggml konverterar inljudet med ffmpeg, och att lägga in ffmpeg i en mobilapp bara för det är att släpa på ett stort beroende. Eftersom Wendo redan spelar in i det format whisper.cpp förväntar sig byter pubspec.yaml ut paketet mot en lokal stub:
dependency_overrides:
  # whisper_ggml konverterar ljudet med ffmpeg; Wendo spelar redan in WAV i 16 kHz mono (se paketet).
  ffmpeg_kit_flutter_new_min:
    path: packages/ffmpeg_kit_stub
Stubben (packages/ffmpeg_kit_stub/lib/ffmpeg_kit.dart) implementerar bara execute, som alltid ”misslyckas”. Vid det felet transkriberar whisper_ggml filen som den är. Bygger du Whisper offline i Flutter med det här paketet och redan spelar in WAV i 16 kHz själv, kan du bli av med ffmpeg på samma sätt.
Vilka Whisper-modeller som finns och hur stora de är
Wendo har ingen modell inbyggd i appen. Under Inställningar › Tal finns sju, definierade i WHISPER_MODELS i lib/core/dictation.dart, i två grupper:
- Flerspråkiga: Tiny (75 MB), Base (142 MB), Small (466 MB) och Turbo, som är
large-v3-turbo(appen visar den som 1.6 GB). - Bara engelska:
tiny.en,base.enochsmall.en, med samma storlek som sina flerspråkiga motsvarigheter.
Storlekarna stämmer med whisper.cpp:s officiella modelltabell (models/README.md i ggml-orgs repo), som anger 75 MiB, 142 MiB, 466 MiB och 1,5 GiB för large-v3-turbo. Skillnaden för Turbo handlar om enheter: 1,5 GiB är ungefär 1,6 GB.
whisper.cpp:s huvud-README anger också ungefär hur mycket minne varje storlek använder: runt 273 MB för tiny, 388 MB för base och 852 MB för small. På en dator spelar det ingen roll. På en telefon som samtidigt har en SSH-session, en terminal och kanske en webbläsare öppen märks det.
Vilken Whisper-modell ska du använda på mobilen
Appens egna beskrivningar sammanfattar det: Tiny är ”Snabbast, lägre precision”, Base ”Snabb, bra precision”, Small ”Långsammare, hög precision” och Turbo ”Högsta precisionen”. För att diktera för en agent är base en bra startpunkt, och därför är den standardvärdet.
.en-modellerna förstår bara engelska. Wendo tvingar fram det i koden, så språkinställningen påverkar dem inte:
// ”.en”-modellerna förstår bara engelska.
final language = whisperModel.endsWith('.en') ? 'en' : settings.whisperLanguage;
Dikterar du alltid på engelska lönar de sig: OpenAI:s Whisper-repo anger att .en-versionerna presterar bättre på engelska, särskilt i storlekarna tiny och base. Blandar du språk, eller pratar svenska med engelska funktionsnamn, använd en flerspråkig modell med fast språk. Automatisk identifiering (auto) är standard, men vid en diktering på tre ord har Whisper väldigt lite ljud att gissa språket på, och att låsa det tar bort den osäkerheten.
Mät fördröjningen på din telefon
Vi publicerar inga transkriberingstider, eftersom de beror på telefonen, modellen och hur länge du pratar. Det Wendo gör är att låta dig mäta själv. Under Inställningar › Tal finns en mikrofonknapp för att testa motorn, och under den igenkända texten visas en rad med motor, modell, språk, format, ljudets längd och fördröjningen i millisekunder. Den kommer från TranscriptionResult, som sparar durationMs och latencyMs för varje transkribering. Prova base och small med samma mening och bestäm utifrån dina egna siffror.
Så laddas en modell ned
Modellerna hämtas från whisper.cpp:s repo på Hugging Face, med standardfilnamnet:
const _hf = 'https://huggingface.co/ggerganov/whisper.cpp/resolve/main';
String _fileName(String id) => 'ggml-$id.bin';
När du trycker på en modell du inte har laddar downloadModel först ned den till en .part-fil i den tillfälliga mappen och flyttar den till appens dokumentmapp när den är klar. Om mapparna ligger på olika volymer och namnbytet inte går kopierar den filen och tar bort den tillfälliga. På så sätt kan en avbruten nedladdning aldrig se ut som en giltig modell.
En modell kan ändå bli skadad. När whisper.cpp svarar ”failed to load the model” visar Wendo inte det råa felet, utan säger att modellen är skadad och ber dig ta bort den under Inställningar › Tal och ladda ned den igen.
Spela in i det format whisper.cpp förväntar sig
whisper.cpp arbetar med 16-bitars WAV PCM i 16 kHz och mono, och dess README ger till och med ffmpeg-kommandot för att konvertera till det formatet. Wendo spelar in så direkt, med record:
const RecordConfig(
  encoder: AudioEncoder.pcm16bits,
  sampleRate: _sampleRate, // 16000
  numChannels: 1,
  androidConfig: AndroidRecordConfig(audioSource: AndroidAudioSource.voiceRecognition),
)
På Android begär appen källan VOICE_RECOGNITION, som är avsedd för taligenkänning. PCM-bitarna samlas i minnet medan du pratar. När du slutar väntar Wendo 200 ms på den sista biten och kastar inspelningar kortare än 0,3 sekunder, som oftast är oavsiktliga tryck. Sedan läggs en RIFF-header på 44 byte framför (encodeWav i lib/components/settings/byok.dart), dictation.wav skrivs till cachen, transkriberas och tas bort i ett finally, oavsett hur det gick.
Modellen ligger kvar laddad mellan dikteringarna (keepModelLoaded: true), så bara den första betalar kostnaden för att ladda den. Byter du modell eller tar bort den som används frigör Wendo först whisper-kontexten.
Städa det Whisper returnerar
Whisper returnerar inte alltid dikterad text. När den inte hör tal skriver den markörer som [BLANK_AUDIO] eller fraser inom parentes i stil med ”(tystnad)”. I en editor stör de inte, i en terminal hamnar de i agentens prompt. _stripNonSpeech tar bort det som står inom hakparenteser med versaler och kastar hela resultatet om det bara är en parentes eller asterisker.
Den städade texten går till editorn eller terminalen. Som standard skrivs den in utan att Enter trycks, så att du kan granska den innan du skickar, om du inte slår på Skicka automatiskt. Varje diktering sparas i en lokal historik (under Inställningar › Tal › Dikteringshistorik) som du kan skicka om den från.
Ordersättningar
Ingen liten modell får till ”tmux”, ”kubectl” eller namnet på ditt projekt. Till det finns ordersättningar: par av ”det Whisper hör” → ”det du menade”. Implementationen ryms på några rader:
// Ordersättningar: i ordning, skiftlägesokänsliga, bara de aktiva.
String applyReplacements(String text) {
  var out = text;
  for (final replacement in getSettings().dictationReplacements) {
    if (!replacement.enabled || replacement.from.isEmpty) continue;
    out = out.replaceAllMapped(RegExp(RegExp.escape(replacement.from), caseSensitive: false), (_) => replacement.to);
  }
  return out;
}
De tillämpas i ordning och utan hänsyn till versaler, de kan stängas av utan att tas bort, och om målet är tomt tas ordet bort. De fungerar likadant med lokal Whisper och med molnet. För egennamnen i ditt jobb är en ersättning billigare än att gå upp till en större modell.
Alternativet: ta med egen nyckel (OpenAI eller Groq)
BYOK-motorn (”bring your own key”) laddar upp samma WAV till en molnleverantör med din API-nyckel. Wendo stöder två, definierade i BYOK_PROVIDERS:
- OpenAI, mot
/v1/audio/transcriptions, medgpt-4o-mini-transcribesom standardmodell. - Groq, mot dess OpenAI-kompatibla endpoint, med
whisper-large-v3-turbosom standard.
Modellfältet går att redigera, så du kan ange en annan som din leverantör stöder. Nyckeln lagras i enhetens nyckelring, en per leverantör, och appen säger på samma skärm att den ”skickas bara” till den valda leverantören. Förfrågan är en multipart med file, model, response_format: json och, om du inte har låtit automatisk identifiering vara kvar, language.
Båda alternativen finns eftersom de löser olika saker. Lokal Whisper är privat, fungerar utan täckning och kostar ingenting per diktering, i utbyte mot att den tar utrymme och minne och beror på telefonens prestanda. Molnet tar inget utrymme på mobilen och ger dig stora modeller som inte får plats i den, men ljudet lämnar enheten, du behöver uppkoppling och du betalar leverantören. Groq kör samma large-v3-turbo som Wendo erbjuder lokalt, med skillnaden att den körs på deras servrar och inte på din telefon. OpenAI lägger till sina egna transkriberingsmodeller.
Vårt råd: börja med base lokalt och några ersättningar. Dikterar du mycket, klarar telefonen knappt stora modeller och har du inget emot att ljudet lämnar mobilen, gå över till BYOK.
Prova det
Dikteringen är en del av Wendo, som ännu inte finns i butikerna. Den startas med mikrofonen i terminalens eller editorns verktygsrad, eller genom att hålla inne tangentbordsknappen, som är standardgesten. Har du inte ställt i ordning datorn för att prata med en agent från mobilen än, börja med hur du använder Claude Code från mobilen, och för att sessionen ska leva medan du dikterar, minimal tmux för kodagenter.