 Lirafy
Whisper na telefonie bez internetu: jak dyktuje Wendo
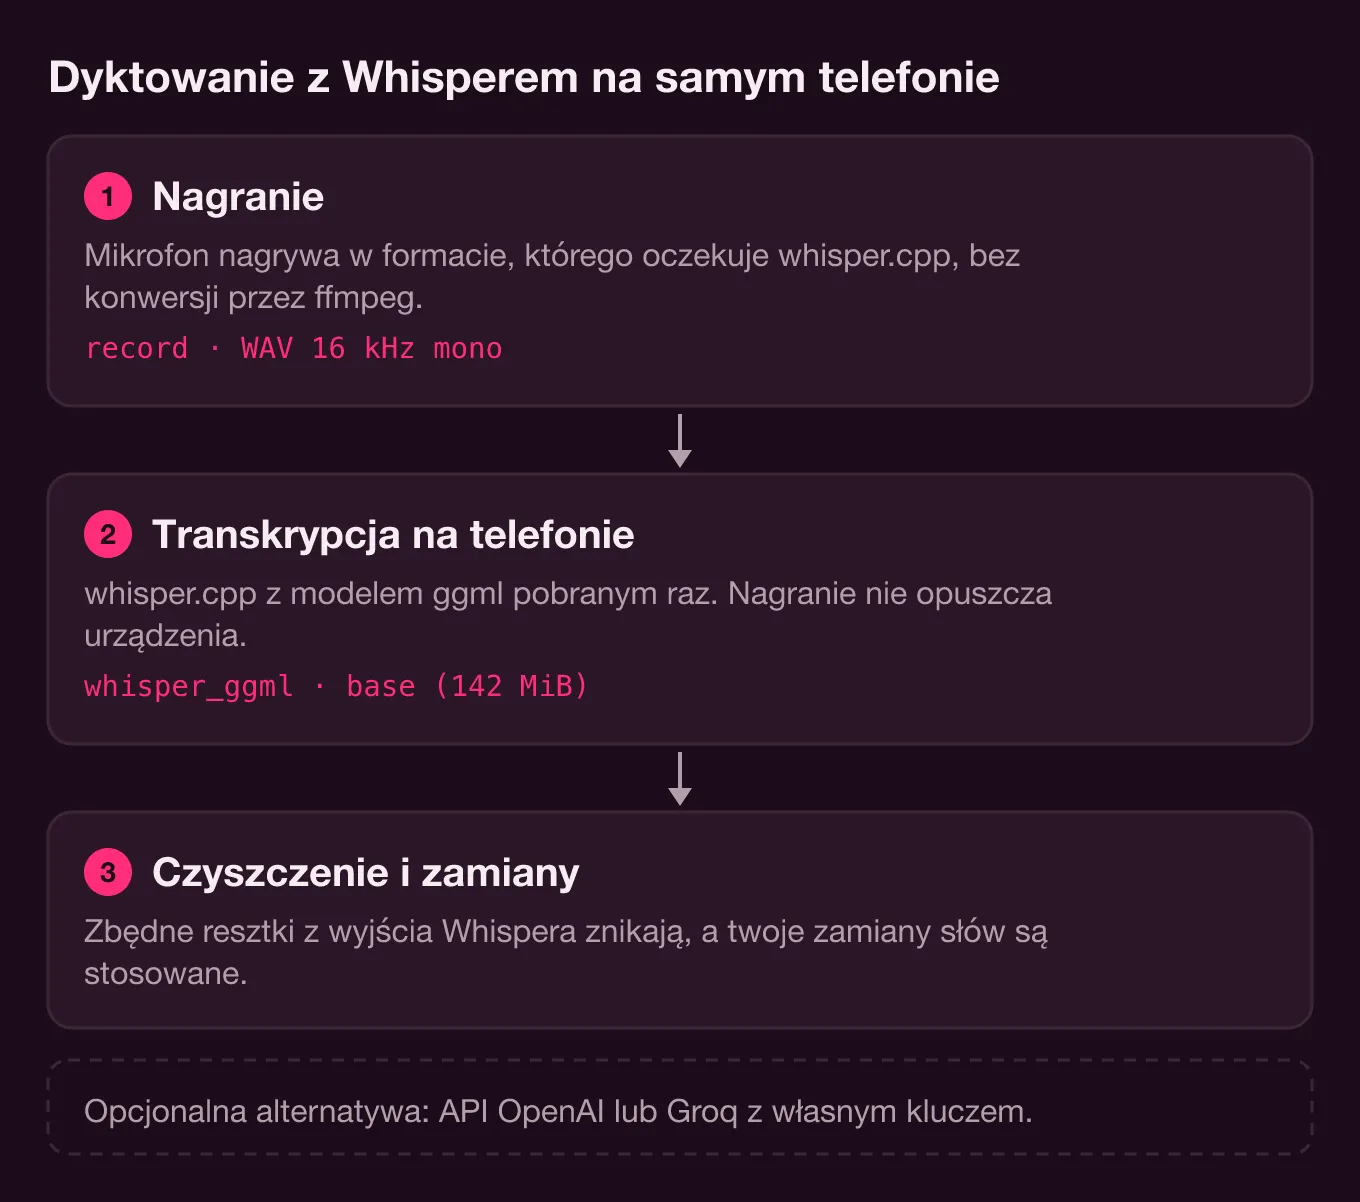
Tak, Whisper działa na telefonie bez internetu. Z whisper.cpp i modelem ggml pobranym raz telefon sam zamienia mowę na tekst, a nagranie nie opuszcza urządzenia. Tak dyktuje Wendo, nasz klient SSH do śledzenia agentów takich jak Claude Code z iOS i Androida. Opisujemy tu, jak to zbudowaliśmy: jakie modele oferuje, jak je pobiera, w jakim formacie nagrywa, co robi z tym, co zwraca Whisper, i dlaczego jest też opcja użycia API OpenAI albo Groq z własnym kluczem.
Whisper bez internetu na telefonie: dlaczego go używamy
Pisanie do agenta kodującego na klawiaturze telefonu jest wolne. Polecenia dla Claude Code to zwykle długie zdania („sprawdź, czemu pada test logowania, i nie ruszaj migracji”), a stukanie ich kciukiem to właśnie ta część, której nikomu się nie chce. Mówienie jest szybsze.
Problemem jest to, co mówisz. Dyktując agentowi, wymieniasz pliki, ścieżki, gałęzie, a czasem sprawy klienta. Wysyłanie takiego nagrania na cudzy serwer do transkrypcji nie zawsze jest w porządku, a przy słabym zasięgu po prostu nie działa. Dlatego domyślnym silnikiem w Wendo jest lokalny Whisper. W lib/core/settings.dart wartość początkowa to speechEngine = 'whisper' z modelem base, a ekran ustawień streszcza to jednym zdaniem: „Whisper transkrybuje na telefonie za pomocą whisper.cpp: żaden dźwięk nie jest wysyłany na serwer.”
whisper.cpp we Flutterze: whisper_ggml i record
whisper.cpp to reimplementacja w C/C++ Whispera, modelu rozpoznawania mowy od OpenAI, korzystająca z formatu wag ggml. Działa na CPU bez ciężkich zależności, a jego repozytorium ma oficjalne przykłady dla iOS i Androida. We Flutterze nie trzeba pisać bindingów ręcznie: na pub.dev jest kilka pakietów, które go opakowują.
Wendo używa dwóch, zgodnie z pubspec.yaml:
record: ^7.1.2
whisper_ggml: ^2.8.1
record nagrywa mikrofon, a whisper_ggml wywołuje whisper.cpp.
Jest szczegół, którego nie widać od razu. whisper_ggml konwertuje dźwięk wejściowy przez ffmpeg, a dokładanie ffmpeg do aplikacji mobilnej tylko w tym celu oznacza dużą zależność. Wendo i tak nagrywa w formacie, którego oczekuje whisper.cpp, więc pubspec.yaml podmienia ten pakiet na lokalny stub:
dependency_overrides:
  # whisper_ggml konwertuje dźwięk przez ffmpeg; Wendo już nagrywa WAV 16 kHz mono (patrz pakiet).
  ffmpeg_kit_flutter_new_min:
    path: packages/ffmpeg_kit_stub
Stub (packages/ffmpeg_kit_stub/lib/ffmpeg_kit.dart) implementuje tylko execute, które zawsze „zawodzi”. Po takiej porażce whisper_ggml transkrybuje plik bez zmian. Jeśli budujesz Whispera offline we Flutterze na tym pakiecie i sam nagrywasz WAV 16 kHz, możesz pozbyć się ffmpeg w ten sam sposób.
Jakie modele Whisper są do wyboru i ile zajmują
Wendo nie ma w środku żadnego modelu. W Ustawienia › Mowa oferuje siedem, zdefiniowanych w WHISPER_MODELS w lib/core/dictation.dart, w dwóch grupach:
- Wielojęzyczne: Tiny (75 MB), Base (142 MB), Small (466 MB) i Turbo, czyli
large-v3-turbo(aplikacja pokazuje go jako 1.6 GB). - Tylko angielskie:
tiny.en,base.enismall.en, o tych samych rozmiarach co ich wielojęzyczne odpowiedniki.
Te rozmiary zgadzają się z oficjalną tabelą modeli whisper.cpp (models/README.md w repozytorium ggml-org), która podaje 75 MiB, 142 MiB, 466 MiB i 1,5 GiB dla large-v3-turbo. Różnica przy Turbo wynika z jednostek: 1,5 GiB to mniej więcej 1,6 GB.
Główny README whisper.cpp podaje też przybliżone zużycie pamięci dla każdego rozmiaru: około 273 MB dla tiny, 388 MB dla base i 852 MB dla small. Na komputerze to bez znaczenia. Na telefonie, na którym jest jeszcze otwarta sesja SSH, terminal i może przeglądarka, już tak.
Jaki model Whispera wybrać na telefon
Opisy w samej aplikacji mówią wszystko: Tiny to „Najszybszy, niższa dokładność”, Base „Szybki, dobra dokładność”, Small „Wolniejszy, bardzo dobra dokładność”, a Turbo „Najwyższa dokładność”. Do dyktowania agentowi base to dobry punkt wyjścia i dlatego jest wartością domyślną.
Modele .en rozumieją tylko angielski. Wendo wymusza to w kodzie, więc ustawienie języka ich nie dotyczy:
// Modele „.en” rozumieją tylko angielski.
final language = whisperModel.endsWith('.en') ? 'en' : settings.whisperLanguage;
Jeśli zawsze dyktujesz po angielsku, opłacają się: repozytorium Whispera od OpenAI podaje, że wersje .en lepiej radzą sobie z angielskim, zwłaszcza w rozmiarach tiny i base. Jeśli mieszasz języki albo mówisz po polsku z angielskimi nazwami funkcji, użyj modelu wielojęzycznego z ustalonym językiem. Automatyczne wykrywanie (auto) jest domyślne, ale przy dyktowaniu trzech słów Whisper ma bardzo mało dźwięku, żeby zgadnąć język, a ustawienie go na sztywno usuwa tę niepewność.
Zmierz opóźnienie na swoim telefonie
Nie publikujemy czasów transkrypcji, bo zależą od telefonu, modelu i tego, jak długo mówisz. Wendo pozwala je zmierzyć samemu. W Ustawienia › Mowa jest przycisk mikrofonu do testowania silnika, a pod rozpoznanym tekstem pojawia się linia z silnikiem, modelem, językiem, formatem, długością nagrania i opóźnieniem w milisekundach. Dane pochodzą z TranscriptionResult, który przy każdej transkrypcji zapisuje durationMs i latencyMs. Wypróbuj base i small na tym samym zdaniu i zdecyduj na podstawie własnych liczb.
Jak pobiera się model
Modele pochodzą z repozytorium whisper.cpp na Hugging Face, ze standardową nazwą pliku:
const _hf = 'https://huggingface.co/ggerganov/whisper.cpp/resolve/main';
String _fileName(String id) => 'ggml-$id.bin';
Gdy stukniesz model, którego nie masz, downloadModel najpierw pobiera go do pliku .part w katalogu tymczasowym, a po zakończeniu przenosi do katalogu dokumentów aplikacji. Jeśli oba katalogi są na różnych woluminach i zmiana nazwy się nie udaje, kopiuje plik i usuwa tymczasowy. Dzięki temu przerwane pobieranie nigdy nie udaje poprawnego modelu.
Model i tak może się uszkodzić. Gdy whisper.cpp odpowiada „failed to load the model”, Wendo nie pokazuje surowego błędu: informuje, że model jest uszkodzony, i prosi, żeby usunąć go w Ustawienia › Mowa i pobrać ponownie.
Nagrywanie w formacie, którego oczekuje whisper.cpp
whisper.cpp pracuje na WAV PCM 16-bitowym, 16 kHz, mono. Jego README podaje nawet polecenie ffmpeg do konwersji na ten format. Wendo od razu nagrywa w ten sposób, przez record:
const RecordConfig(
  encoder: AudioEncoder.pcm16bits,
  sampleRate: _sampleRate, // 16000
  numChannels: 1,
  androidConfig: AndroidRecordConfig(audioSource: AndroidAudioSource.voiceRecognition),
)
Na Androidzie aplikacja prosi o źródło VOICE_RECOGNITION, przeznaczone do rozpoznawania mowy. Fragmenty PCM zbierają się w pamięci, gdy mówisz. Po zatrzymaniu Wendo czeka 200 ms na ostatni fragment i odrzuca nagrania krótsze niż 0,3 sekundy, bo to zwykle przypadkowe dotknięcia. Potem dokleja 44-bajtowy nagłówek RIFF (encodeWav w lib/components/settings/byok.dart), zapisuje dictation.wav w cache, transkrybuje i usuwa plik w bloku finally, niezależnie od wyniku.
Model zostaje załadowany między dyktowaniami (keepModelLoaded: true), więc koszt ładowania ponosi tylko pierwsze. Jeśli zmienisz model albo usuniesz ten, który jest w użyciu, Wendo najpierw zwalnia kontekst whispera.
Czyszczenie tego, co zwraca Whisper
Whisper nie zawsze zwraca podyktowany tekst. Gdy nie słyszy mowy, wypisuje znaczniki w rodzaju [BLANK_AUDIO] albo zdania w nawiasach typu „(cisza)”. W edytorze nie przeszkadzają, w terminalu lądują w prompcie agenta. _stripNonSpeech usuwa to, co stoi w nawiasach kwadratowych wielkimi literami, i odrzuca cały wynik, jeśli to tylko nawias albo gwiazdki.
Oczyszczony tekst trafia do edytora lub terminala. Domyślnie jest wpisywany bez naciskania Enter, żebyś mógł go przejrzeć przed wysłaniem, chyba że włączysz Automatyczne wysyłanie. Każde dyktowanie zostaje w lokalnej historii (Ustawienia › Mowa › Historia dyktowania), skąd możesz wysłać je ponownie.
Zamiany słów
Żaden mały model nie trafi z „tmux”, „kubectl” czy nazwą twojego projektu. Do tego służą zamiany słów: pary „co usłyszał Whisper” → „co chciałeś powiedzieć”. Implementacja mieści się w kilku linijkach:
// Zamiany słów: po kolei, bez rozróżniania wielkości liter, tylko aktywne.
String applyReplacements(String text) {
  var out = text;
  for (final replacement in getSettings().dictationReplacements) {
    if (!replacement.enabled || replacement.from.isEmpty) continue;
    out = out.replaceAllMapped(RegExp(RegExp.escape(replacement.from), caseSensitive: false), (_) => replacement.to);
  }
  return out;
}
Stosowane są po kolei i bez rozróżniania wielkości liter, można je wyłączyć bez usuwania, a jeśli cel jest pusty, słowo znika. Działają tak samo z lokalnym Whisperem i z chmurą. Na nazwy własne z twojej pracy zamiana wychodzi taniej niż przejście na większy model.
Alternatywa: własny klucz (OpenAI lub Groq)
Silnik BYOK („bring your own key”) wysyła ten sam plik WAV do dostawcy w chmurze z twoim kluczem API. Wendo obsługuje dwóch, zdefiniowanych w BYOK_PROVIDERS:
- OpenAI, przez
/v1/audio/transcriptions, zgpt-4o-mini-transcribejako modelem domyślnym. - Groq, przez jego endpoint zgodny z OpenAI, domyślnie z
whisper-large-v3-turbo.
Pole modelu można edytować, więc wpiszesz inny, jeśli twój dostawca go obsługuje. Klucz jest przechowywany w pęku kluczy urządzenia, osobno dla każdego dostawcy, a aplikacja mówi na tym samym ekranie, że jest „wysyłany tylko” do wybranego dostawcy. Żądanie to multipart z file, model, response_format: json i, jeśli nie zostawiłeś automatycznego wykrywania, language.
Obie opcje istnieją, bo rozwiązują różne problemy. Lokalny Whisper jest prywatny, działa bez zasięgu i nic nie kosztuje za dyktowanie, ale zajmuje miejsce i pamięć i zależy od mocy telefonu. Chmura nie zajmuje nic na telefonie i daje duże modele, które się na nim nie mieszczą, ale nagranie opuszcza urządzenie, potrzebujesz połączenia i płacisz dostawcy. Groq serwuje ten sam large-v3-turbo, który Wendo oferuje lokalnie, tyle że uruchamia go na swoich serwerach, a nie na twoim telefonie. OpenAI dokłada własne modele transkrypcji.
Nasza rada: zacznij od lokalnego base i kilku zamian. Jeśli dyktujesz dużo, telefon ledwo radzi sobie z dużymi modelami i nie przeszkadza ci, że nagranie wychodzi z telefonu, przejdź na BYOK.
Jak to wypróbować
Dyktowanie jest częścią Wendo, którego jeszcze nie ma w sklepach. Włącza się je mikrofonem na pasku terminala lub edytora albo przytrzymując przycisk klawiatury, co jest domyślnym gestem. Jeśli nie masz jeszcze komputera przygotowanego do rozmowy z agentem z telefonu, zacznij od tego, jak używać Claude Code z telefonu, a żeby sesja żyła, gdy dyktujesz, przeczytaj o minimalnym tmux dla agentów kodujących.