 Lirafy
Whisper auf dem Handy, ohne Internet: so diktiert Wendo
Ja, Whisper läuft offline auf dem Handy. Mit whisper.cpp und einem einmal heruntergeladenen ggml-Modell transkribiert das Telefon die Sprache selbst, und das Audio verlässt das Gerät nicht. So diktiert Wendo, unser SSH-Client, mit dem du Agenten wie Claude Code von iOS und Android aus verfolgst.
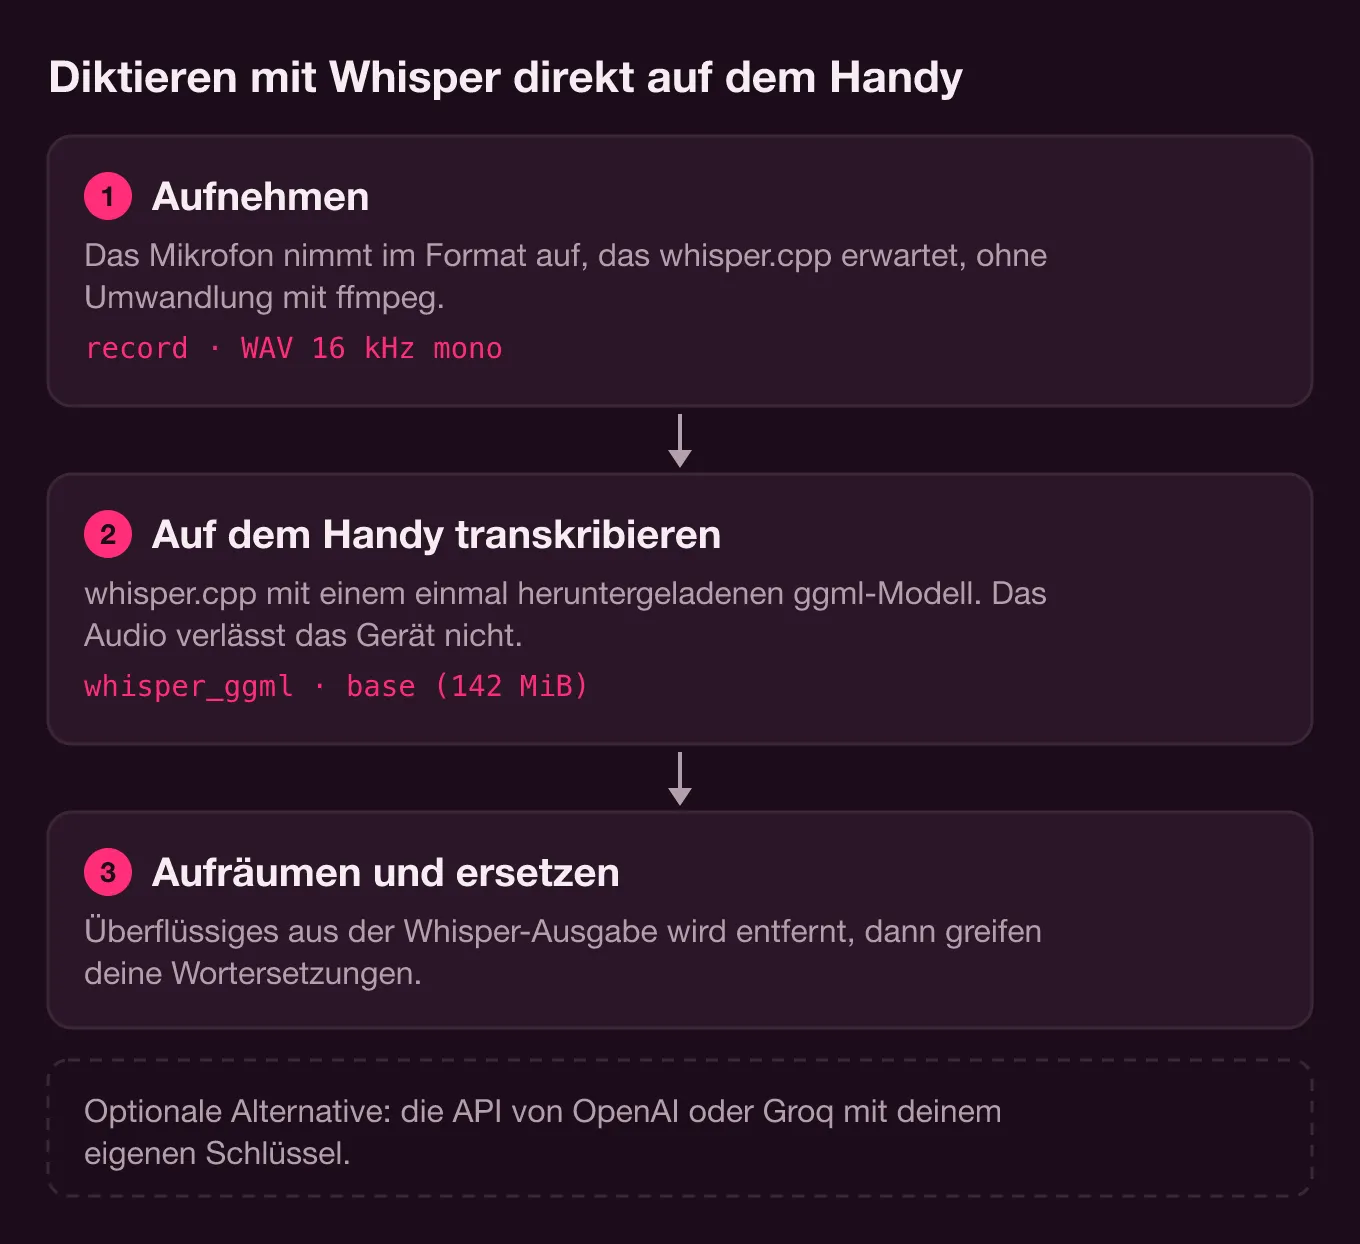
Hier erzählen wir, wie das gebaut ist: welche Modelle es gibt, wie sie heruntergeladen werden, in welchem Format aufgenommen wird, was mit der Ausgabe von Whisper passiert und warum es zusätzlich die Option gibt, die API von OpenAI oder Groq mit deinem eigenen Schlüssel zu nutzen.
Whisper offline auf dem Handy: warum wir es nutzen
Einem Coding-Agenten über die Handytastatur zu schreiben, ist langsam. Anweisungen für Claude Code sind meist lange Sätze („schau, warum der Login-Test fehlschlägt, und fass die Migration nicht an“), und genau die mit dem Daumen zu tippen, ist der lästige Teil. Sprechen geht schneller.
Das Problem ist, was du sagst. Beim Diktieren an einen Agenten nennst du Dateien, Pfade, Branches und manchmal Dinge von Kunden. Dieses Audio an einen fremden Server zu schicken, damit Text daraus wird, will man nicht immer, und bei schlechtem Empfang klappt es nicht einmal. Deshalb ist die Standard-Engine von Wendo lokales Whisper. In lib/core/settings.dart steht als Anfangswert speechEngine = 'whisper' mit dem Modell base, und der Einstellungsbildschirm fasst es in einer Zeile zusammen: „Whisper transkribiert auf dem Handy mit whisper.cpp: Es wird kein Audio an einen Server gesendet.“
whisper.cpp in Flutter: whisper_ggml und record
whisper.cpp ist die Neuimplementierung von Whisper, dem Spracherkennungsmodell von OpenAI, in C/C++ und nutzt das Gewichtsformat ggml. Es läuft ohne schwere Abhängigkeiten auf der CPU, und sein Repository bringt offizielle Beispiele für iOS und Android mit. In Flutter muss man die Bindings nicht selbst schreiben: Auf pub.dev gibt es mehrere Pakete, die es kapseln.
Wendo nutzt laut seiner pubspec.yaml zwei davon:
record: ^7.1.2
whisper_ggml: ^2.8.1
record nimmt das Mikrofon auf, und whisper_ggml ruft whisper.cpp auf.
Ein Detail sieht man nicht auf den ersten Blick. whisper_ggml wandelt das Eingangsaudio mit ffmpeg um, und ffmpeg nur dafür in eine mobile App zu packen, heißt eine große Abhängigkeit mitzuschleppen. Da Wendo schon im Format aufnimmt, das whisper.cpp erwartet, ersetzt die pubspec.yaml dieses Paket durch einen lokalen Stub:
dependency_overrides:
  # whisper_ggml wandelt das Audio mit ffmpeg um; Wendo nimmt schon WAV mit 16 kHz mono auf (siehe das Paket).
  ffmpeg_kit_flutter_new_min:
    path: packages/ffmpeg_kit_stub
Der Stub (packages/ffmpeg_kit_stub/lib/ffmpeg_kit.dart) implementiert nur execute, das immer „scheitert“. Bei diesem Fehlschlag transkribiert whisper_ggml die Datei so, wie sie ist. Wenn du Whisper offline in Flutter mit diesem Paket baust und die Aufnahme schon selbst als WAV mit 16 kHz machst, wirst du ffmpeg auf dieselbe Weise los.
Welche Whisper-Modelle es gibt und wie groß sie sind
Wendo bringt kein Modell in der App mit. Unter Einstellungen › Sprache stehen sieben zur Wahl, definiert in WHISPER_MODELS in lib/core/dictation.dart, in zwei Gruppen:
- Mehrsprachig: Tiny (75 MB), Base (142 MB), Small (466 MB) und Turbo, also
large-v3-turbo(die App zeigt es als 1.6 GB an). - Nur Englisch:
tiny.en,base.enundsmall.en, mit denselben Größen wie ihre mehrsprachigen Versionen.
Diese Größen stimmen mit der offiziellen Modelltabelle von whisper.cpp überein (models/README.md im Repository von ggml-org), die 75 MiB, 142 MiB, 466 MiB und 1,5 GiB für large-v3-turbo angibt. Beim Turbo liegt der Unterschied nur an den Einheiten: 1,5 GiB sind etwa 1,6 GB.
Das Haupt-README von whisper.cpp nennt außerdem den ungefähren Speicherbedarf jeder Größe: etwa 273 MB für tiny, 388 MB für base und 852 MB für small. Auf einem Rechner ist das egal. Auf einem Handy, auf dem gleichzeitig eine SSH-Sitzung, ein Terminal und vielleicht ein Browser offen sind, merkt man es.
Welches Whisper-Modell du auf dem Handy nimmst
Die Beschreibungen in der App fassen es zusammen: Tiny ist „Am schnellsten, geringere Genauigkeit“, Base „Schnell, gute Genauigkeit“, Small „Langsamer, hohe Genauigkeit“ und Turbo „Höchste Genauigkeit“. Zum Diktieren an einen Agenten ist base ein guter Ausgangspunkt, und deshalb ist es der Standard.
Die .en-Modelle verstehen nur Englisch. Wendo erzwingt das im Code, die Spracheinstellung wirkt sich auf sie also nicht aus:
// Die „.en“-Modelle verstehen nur Englisch.
final language = whisperModel.endsWith('.en') ? 'en' : settings.whisperLanguage;
Wenn du immer auf Englisch diktierst, lohnen sie sich: Laut dem Whisper-Repository von OpenAI schneiden die .en-Versionen auf Englisch besser ab, vor allem bei tiny und base. Wenn du Sprachen mischst oder auf Deutsch mit englischen Funktionsnamen sprichst, nimm ein mehrsprachiges Modell mit fest eingestellter Sprache. Die automatische Erkennung (auto) ist der Standard, aber bei einem Diktat aus drei Wörtern hat Whisper sehr wenig Audio, um die Sprache zu erraten, und eine feste Einstellung nimmt dir diese Unsicherheit.
Miss die Latenz auf deinem Handy
Wir veröffentlichen keine Transkriptionszeiten, weil sie vom Telefon, vom Modell und davon abhängen, wie lange du sprichst. Wendo lässt dich stattdessen selbst messen. Unter Einstellungen › Sprache gibt es einen Mikrofonknopf zum Testen der Engine, und unter dem erkannten Text erscheint eine Zeile mit Engine, Modell, Sprache, Format, Audiodauer und Latenz in Millisekunden. Sie kommt aus TranscriptionResult, das bei jeder Transkription durationMs und latencyMs speichert. Probier base und small mit demselben Satz aus und entscheide nach deinen eigenen Zahlen.
Wie ein Modell heruntergeladen wird
Die Modelle kommen aus dem whisper.cpp-Repository auf Hugging Face, mit dem üblichen Dateinamen:
const _hf = 'https://huggingface.co/ggerganov/whisper.cpp/resolve/main';
String _fileName(String id) => 'ggml-$id.bin';
Tippst du auf ein Modell, das du nicht hast, lädt downloadModel es zuerst in eine .part-Datei im temporären Ordner und verschiebt es nach Abschluss in den Dokumentenordner der App. Liegen beide Ordner auf verschiedenen Volumes und lässt sich die Datei nicht umbenennen, kopiert es sie und löscht die temporäre. So geht ein abgebrochener Download nie als gültiges Modell durch.
Trotzdem kann ein Modell beschädigt werden. Antwortet whisper.cpp mit „failed to load the model“, zeigt Wendo nicht den rohen Fehler, sondern meldet, dass das Modell beschädigt ist, und bittet dich, es unter Einstellungen › Sprache zu löschen und neu herunterzuladen.
Aufnehmen im Format, das whisper.cpp erwartet
whisper.cpp arbeitet mit 16-Bit-PCM-WAV bei 16 kHz in Mono; sein README nennt sogar den ffmpeg-Befehl, um in dieses Format umzuwandeln. Wendo nimmt direkt so auf, mit record:
const RecordConfig(
  encoder: AudioEncoder.pcm16bits,
  sampleRate: _sampleRate, // 16000
  numChannels: 1,
  androidConfig: AndroidRecordConfig(audioSource: AndroidAudioSource.voiceRecognition),
)
Auf Android fordert es die Quelle VOICE_RECOGNITION an, die für Spracherkennung gedacht ist. Die PCM-Stücke sammeln sich im Speicher, während du sprichst. Beim Stoppen wartet Wendo 200 ms auf das letzte Stück und verwirft Aufnahmen unter 0,3 Sekunden, meist versehentliches Antippen. Danach setzt es einen 44 Byte großen RIFF-Header davor (encodeWav in lib/components/settings/byok.dart), schreibt dictation.wav in den Cache, transkribiert und löscht die Datei in einem finally, ob es geklappt hat oder nicht.
Das Modell bleibt zwischen den Diktaten geladen (keepModelLoaded: true), also zahlt nur das erste die Ladezeit. Wechselst du das Modell oder löschst das gerade genutzte, gibt Wendo vorher den Whisper-Kontext frei.
Aufräumen, was Whisper zurückgibt
Whisper liefert nicht immer diktierten Text. Hört es keine Sprache, schreibt es Markierungen wie [BLANK_AUDIO] oder Sätze in Klammern wie „(Stille)“. In einem Editor stören sie nicht, in einem Terminal landen sie im Prompt des Agenten. _stripNonSpeech entfernt alles in eckigen Klammern in Großbuchstaben und verwirft das ganze Ergebnis, wenn es nur aus einer Klammer oder aus Sternchen besteht.
Der bereinigte Text geht in den Editor oder ins Terminal. Standardmäßig wird er ohne Enter geschrieben, damit du ihn vor dem Absenden prüfen kannst, außer du schaltest Auto-Senden ein. Jedes Diktat landet in einem lokalen Verlauf (unter Einstellungen › Sprache › Diktatverlauf), aus dem du es erneut senden kannst.
Wortersetzungen
Kein kleines Modell trifft „tmux“, „kubectl“ oder den Namen deines Projekts. Dafür gibt es Wortersetzungen: Paare aus „was Whisper verstanden hat“ → „was du sagen wolltest“. Die Implementierung passt in ein paar Zeilen:
// Wortersetzungen: der Reihe nach, ohne Groß-/Kleinschreibung, nur die aktiven.
String applyReplacements(String text) {
  var out = text;
  for (final replacement in getSettings().dictationReplacements) {
    if (!replacement.enabled || replacement.from.isEmpty) continue;
    out = out.replaceAllMapped(RegExp(RegExp.escape(replacement.from), caseSensitive: false), (_) => replacement.to);
  }
  return out;
}
Sie werden der Reihe nach und ohne Rücksicht auf Groß- und Kleinschreibung angewendet, lassen sich deaktivieren, ohne sie zu löschen, und ist das Ziel leer, wird das Wort entfernt. Sie funktionieren mit lokalem Whisper genauso wie mit der Cloud. Für die Eigennamen aus deiner Arbeit ist eine Ersetzung günstiger als ein größeres Modell.
Die Alternative: eigener Schlüssel (OpenAI oder Groq)
Die BYOK-Engine („bring your own key“) lädt dasselbe WAV mit deinem API-Schlüssel zu einem Cloud-Anbieter hoch. Wendo unterstützt zwei, definiert in BYOK_PROVIDERS:
- OpenAI, über
/v1/audio/transcriptions, mitgpt-4o-mini-transcribeals Standardmodell. - Groq, über seinen OpenAI-kompatiblen Endpunkt, standardmäßig mit
whisper-large-v3-turbo.
Das Modellfeld ist editierbar, du kannst also ein anderes eintragen, das dein Anbieter unterstützt. Der Schlüssel wird im Schlüsselbund des Geräts gespeichert, einer pro Anbieter, und auf demselben Bildschirm steht, dass er „nur an“ den gewählten Anbieter gesendet wird. Die Anfrage ist ein Multipart mit file, model, response_format: json und, wenn du nicht bei der automatischen Erkennung bleibst, language.
Beide Optionen gibt es, weil sie verschiedene Probleme lösen. Lokales Whisper ist privat, funktioniert ohne Empfang und kostet pro Diktat nichts, braucht dafür Speicherplatz und Arbeitsspeicher und hängt von der Leistung des Telefons ab. Die Cloud belegt nichts auf dem Handy und bietet große Modelle, die nicht darauf passen, aber das Audio verlässt das Gerät, du brauchst eine Verbindung und bezahlst den Anbieter. Groq liefert dasselbe large-v3-turbo, das Wendo lokal anbietet, nur läuft es dort auf Groqs Servern statt auf deinem Telefon. OpenAI ergänzt seine eigenen Transkriptionsmodelle.
Unsere Empfehlung: Fang lokal mit base und ein paar Ersetzungen an. Wenn du viel diktierst, dein Handy mit großen Modellen an seine Grenzen kommt und es dich nicht stört, dass das Audio das Gerät verlässt, wechsle zu BYOK.
Ausprobieren
Das Diktieren ist ein Teil von Wendo, das noch nicht in den Stores ist. Du startest es mit dem Mikrofon in der Leiste des Terminals oder des Editors oder, als voreingestellte Geste, indem du den Tastaturknopf gedrückt hältst. Wenn dein Rechner noch nicht dafür eingerichtet ist, vom Handy aus mit einem Agenten zu sprechen, fang mit Claude Code vom Handy aus nutzen an, und damit die Sitzung weiterläuft, während du diktierst, mit dem minimalen tmux für Coding-Agenten.