 Lirafy
Whisper на телефоне без интернета: как диктует Wendo
Да, Whisper работает на телефоне без интернета. С whisper.cpp и моделью ggml, скачанной один раз, телефон сам переводит голос в текст, и запись не покидает устройство. Так диктует Wendo, наш SSH-клиент для работы с агентами вроде Claude Code с iOS и Android. Здесь рассказываем, как это сделано: какие модели есть, как они скачиваются, в каком формате идёт запись, что приложение делает с ответом Whisper и зачем есть вариант с API OpenAI или Groq и твоим собственным ключом.
Whisper без интернета на телефоне: зачем он нам
Писать агенту с клавиатуры телефона медленно. Инструкции для Claude Code обычно длинные («посмотри, почему падает тест логина, и не трогай миграцию»), и набирать их большим пальцем лень больше всего. Говорить быстрее.
Проблема в том, что именно ты говоришь. Диктуя агенту, ты называешь файлы, пути, ветки, а иногда и дела клиента. Отправлять такую запись на чужой сервер ради расшифровки хочется не всегда, а при плохой связи это просто не работает. Поэтому движок по умолчанию в Wendo — локальный Whisper. В lib/core/settings.dart начальное значение speechEngine = 'whisper' с моделью base, а экран настроек описывает это одной строкой: «Whisper распознаёт речь на телефоне через whisper.cpp: аудио не отправляется ни на какой сервер».
whisper.cpp во Flutter: whisper_ggml и record
whisper.cpp — переписанный на C/C++ Whisper, модель распознавания речи от OpenAI, с весами в формате ggml. Он работает на CPU без тяжёлых зависимостей, а в его репозитории есть официальные примеры для iOS и Android. Во Flutter писать биндинги вручную не нужно: на pub.dev есть несколько пакетов-обёрток.
Wendo использует два, судя по pubspec.yaml:
record: ^7.1.2
whisper_ggml: ^2.8.1
record пишет микрофон, а whisper_ggml вызывает whisper.cpp.
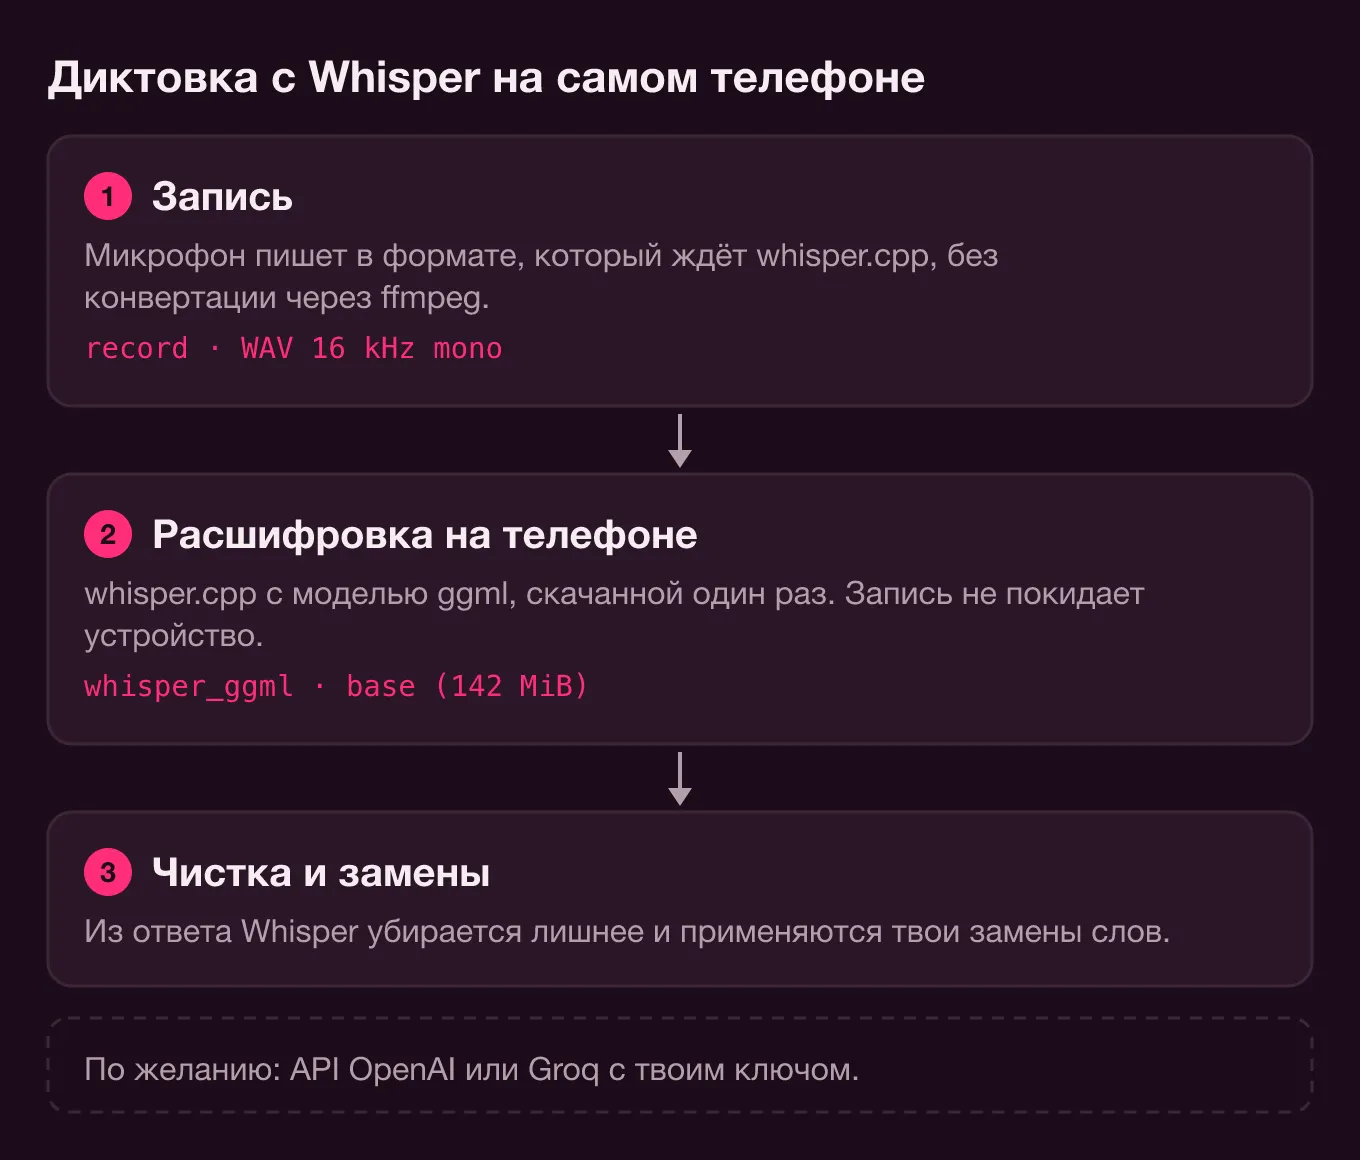
Есть деталь, которую не видно сразу. whisper_ggml конвертирует входной звук через ffmpeg, а тащить ffmpeg в мобильное приложение только ради этого — большая зависимость. Wendo и так пишет в формате, который ждёт whisper.cpp, поэтому pubspec.yaml подменяет этот пакет локальной заглушкой:
dependency_overrides:
  # whisper_ggml конвертирует звук через ffmpeg; Wendo уже пишет WAV 16 кГц моно (см. пакет).
  ffmpeg_kit_flutter_new_min:
    path: packages/ffmpeg_kit_stub
Заглушка (packages/ffmpeg_kit_stub/lib/ffmpeg_kit.dart) реализует только execute, который всегда «падает». После такой ошибки whisper_ggml расшифровывает файл как есть. Если ты собираешь офлайн-Whisper во Flutter на этом пакете и сам пишешь WAV 16 кГц, от ffmpeg можно избавиться так же.
Какие модели Whisper доступны и сколько они весят
Wendo не вшивает в приложение ни одной модели. В разделе Настройки › Речь их семь, они описаны в WHISPER_MODELS в lib/core/dictation.dart и разбиты на две группы:
- Многоязычные: Tiny (75 MB), Base (142 MB), Small (466 MB) и Turbo, то есть
large-v3-turbo(приложение показывает его как 1.6 GB). - Только английский:
tiny.en,base.enиsmall.en, того же размера, что их многоязычные версии.
Эти размеры совпадают с официальной таблицей моделей whisper.cpp (models/README.md в репозитории ggml-org), где указано 75 MiB, 142 MiB, 466 MiB и 1,5 GiB для large-v3-turbo. Разница у Turbo — в единицах: 1,5 GiB это примерно 1,6 GB.
В основном README whisper.cpp приведён и примерный расход памяти для каждого размера: около 273 MB у tiny, 388 MB у base и 852 MB у small. На компьютере это неважно. На телефоне, где параллельно открыты SSH-сессия, терминал и, может быть, браузер, разница заметна.
Какую модель Whisper выбрать для телефона
Описания в самом приложении говорят всё: Tiny — «Самая быстрая, ниже точность», Base — «Быстрая, хорошая точность», Small — «Медленнее, отличная точность», Turbo — «Наивысшая точность». Для диктовки агенту base — хорошая отправная точка, поэтому она и стоит по умолчанию.
Модели .en понимают только английский. Wendo задаёт это в коде, так что настройка языка на них не влияет:
// Модели «.en» понимают только английский.
final language = whisperModel.endsWith('.en') ? 'en' : settings.whisperLanguage;
Если ты всегда диктуешь по-английски, они того стоят: в репозитории Whisper от OpenAI сказано, что версии .en лучше справляются с английским, особенно в размерах tiny и base. Если ты смешиваешь языки или говоришь по-русски с английскими названиями функций, бери многоязычную модель с фиксированным языком. Автоопределение (auto) включено по умолчанию, но в диктовке из трёх слов у Whisper слишком мало звука, чтобы угадать язык, а фиксированный язык снимает этот вопрос.
Измерь задержку на своём телефоне
Мы не публикуем время расшифровки: оно зависит от телефона, модели и того, сколько ты говоришь. Зато Wendo позволяет измерить его самому. В Настройки › Речь есть кнопка микрофона для проверки движка, а под распознанным текстом появляется строка с движком, моделью, языком, форматом, длительностью записи и задержкой в миллисекундах. Данные берутся из TranscriptionResult, который сохраняет durationMs и latencyMs для каждой расшифровки. Попробуй base и small на одной фразе и решай по своим цифрам.
Как скачивается модель
Модели берутся из репозитория whisper.cpp на Hugging Face, со стандартным именем файла:
const _hf = 'https://huggingface.co/ggerganov/whisper.cpp/resolve/main';
String _fileName(String id) => 'ggml-$id.bin';
Когда ты нажимаешь на модель, которой у тебя нет, downloadModel сначала качает её в файл .part во временной папке, а по завершении переносит в папку документов приложения. Если папки на разных томах и переименовать не получается, файл копируется, а временный удаляется. Так прерванная загрузка никогда не выдаёт себя за рабочую модель.
Модель всё равно может повредиться. Когда whisper.cpp отвечает «failed to load the model», Wendo не показывает сырую ошибку: сообщает, что модель повреждена, и просит удалить её в Настройки › Речь и скачать заново.
Запись в формате, который ждёт whisper.cpp
whisper.cpp работает с 16-битным WAV PCM, 16 кГц, моно. В его README даже есть команда ffmpeg для конвертации в этот формат. Wendo сразу пишет так, через record:
const RecordConfig(
  encoder: AudioEncoder.pcm16bits,
  sampleRate: _sampleRate, // 16000
  numChannels: 1,
  androidConfig: AndroidRecordConfig(audioSource: AndroidAudioSource.voiceRecognition),
)
На Android приложение запрашивает источник VOICE_RECOGNITION, предназначенный для распознавания речи. Куски PCM копятся в памяти, пока ты говоришь. После остановки Wendo ждёт 200 мс последний кусок и выбрасывает записи короче 0,3 секунды: обычно это случайные касания. Затем добавляет спереди 44-байтовый заголовок RIFF (encodeWav в lib/components/settings/byok.dart), пишет dictation.wav в кэш, расшифровывает и удаляет файл в finally, чем бы всё ни кончилось.
Модель остаётся загруженной между диктовками (keepModelLoaded: true), так что цену загрузки платит только первая. Если ты меняешь модель или удаляешь ту, что используется, Wendo сначала освобождает контекст whisper.
Чистка того, что возвращает Whisper
Whisper не всегда возвращает надиктованный текст. Когда он не слышит речи, он пишет метки вроде [BLANK_AUDIO] или фразы в скобках в духе «(тишина)». В редакторе они не мешают, а в терминале попадают в промпт агента. _stripNonSpeech убирает то, что стоит в квадратных скобках заглавными буквами, и отбрасывает весь результат, если там только скобки или звёздочки.
Очищенный текст уходит в редактор или терминал. По умолчанию он вставляется без нажатия Enter, чтобы ты мог проверить его перед отправкой, если только не включить Автоотправка. Каждая диктовка сохраняется в локальной истории (Настройки › Речь › История диктовки), откуда её можно отправить снова.
Замены слов
Ни одна маленькая модель не угадает «tmux», «kubectl» или название твоего проекта. Для этого есть замены слов: пары «что услышал Whisper» → «что ты имел в виду». Реализация укладывается в несколько строк:
// Замены слов: по порядку, без учёта регистра, только активные.
String applyReplacements(String text) {
  var out = text;
  for (final replacement in getSettings().dictationReplacements) {
    if (!replacement.enabled || replacement.from.isEmpty) continue;
    out = out.replaceAllMapped(RegExp(RegExp.escape(replacement.from), caseSensitive: false), (_) => replacement.to);
  }
  return out;
}
Они применяются по порядку и без учёта регистра, их можно отключить, не удаляя, а если замена пустая, слово просто исчезает. Работают одинаково с локальным Whisper и с облаком. Для имён собственных из твоей работы замена обходится дешевле, чем переход на модель побольше.
Альтернатива: свой ключ (OpenAI или Groq)
Движок BYOK («bring your own key») отправляет тот же WAV облачному провайдеру с твоим API-ключом. Wendo поддерживает двух, они описаны в BYOK_PROVIDERS:
- OpenAI, через
/v1/audio/transcriptions, с моделью по умолчаниюgpt-4o-mini-transcribe. - Groq, через его совместимый с OpenAI эндпоинт, по умолчанию с
whisper-large-v3-turbo.
Поле модели редактируется, так что можно указать другую, если её поддерживает твой провайдер. Ключ хранится в связке ключей устройства, отдельно для каждого провайдера, и приложение прямо на том же экране пишет, что он «отправляется только» выбранному провайдеру. Запрос — multipart с file, model, response_format: json и, если ты не оставил автоопределение, language.
Оба варианта есть потому, что решают разные задачи. Локальный Whisper приватен, работает без связи и ничего не стоит за диктовку, но занимает место и память и зависит от мощности телефона. Облако ничего не занимает на телефоне и даёт большие модели, которые на нём не помещаются, но запись покидает устройство, нужна связь и ты платишь провайдеру. Groq запускает ту же large-v3-turbo, которую Wendo предлагает локально, только на своих серверах, а не на твоём телефоне. OpenAI добавляет собственные модели транскрибации.
Наш совет: начни с локальной base и нескольких замен. Если диктуешь много, телефон еле тянет большие модели и тебя не смущает, что запись уходит с телефона, переходи на BYOK.
Попробовать
Диктовка — часть Wendo, которого пока нет в магазинах приложений. Она включается микрофоном на панели терминала или редактора либо удержанием кнопки клавиатуры, это жест по умолчанию. Если компьютер ещё не настроен для работы с агентом с телефона, начни с того, как пользоваться Claude Code с телефона, а чтобы сессия жила, пока ты диктуешь, прочитай про минимальный tmux для кодинг-агентов.