 Lirafy
Whisper op je telefoon, zonder internet: zo dicteert Wendo
Ja, Whisper werkt op je telefoon zonder internet. Met whisper.cpp en een ggml-model dat je één keer downloadt, zet de telefoon spraak zelf om in tekst en verlaat de audio het toestel niet. Zo dicteert Wendo, onze SSH-client om agents als Claude Code vanaf iOS en Android te volgen.
Hier vertellen we hoe het gebouwd is: welke modellen er zijn, hoe ze gedownload worden, in welk formaat de app opneemt, wat hij doet met wat Whisper teruggeeft en waarom je ook de API van OpenAI of Groq met je eigen sleutel kunt gebruiken.
Whisper zonder internet op je telefoon: waarom we het gebruiken
Een coding agent iets schrijven via het toetsenbord van je telefoon gaat traag. Instructies voor Claude Code zijn meestal lange zinnen (“kijk waarom de login-test faalt en blijf van de migratie af”), en die met je duim intikken is precies het stuk waar je geen zin in hebt. Praten gaat sneller.
Het probleem is wat je zegt. Als je een agent iets dicteert, noem je bestanden, paden, branches en soms dingen van een klant. Die audio naar de server van een ander sturen om er tekst van te maken wil je niet altijd, en met slecht bereik werkt het niet eens. Daarom is de standaard-engine van Wendo Whisper, lokaal. In lib/core/settings.dart is de beginwaarde speechEngine = 'whisper' met het model base, en het instellingenscherm vat het samen in één regel: “Whisper transcribeert op de telefoon met whisper.cpp: er wordt geen audio naar een server verzonden”.
whisper.cpp in Flutter: whisper_ggml en record
whisper.cpp is de herimplementatie in C/C++ van Whisper, het spraakherkenningsmodel van OpenAI, en gebruikt het gewichtenformaat ggml. Het draait op de CPU zonder zware dependencies en de repository bevat officiële voorbeelden voor iOS en Android. In Flutter hoef je de bindings niet zelf te schrijven: op pub.dev staan meerdere pakketten die het verpakken.
Wendo gebruikt er twee, volgens de pubspec.yaml:
record: ^7.1.2
whisper_ggml: ^2.8.1
record neemt de microfoon op en whisper_ggml roept whisper.cpp aan.
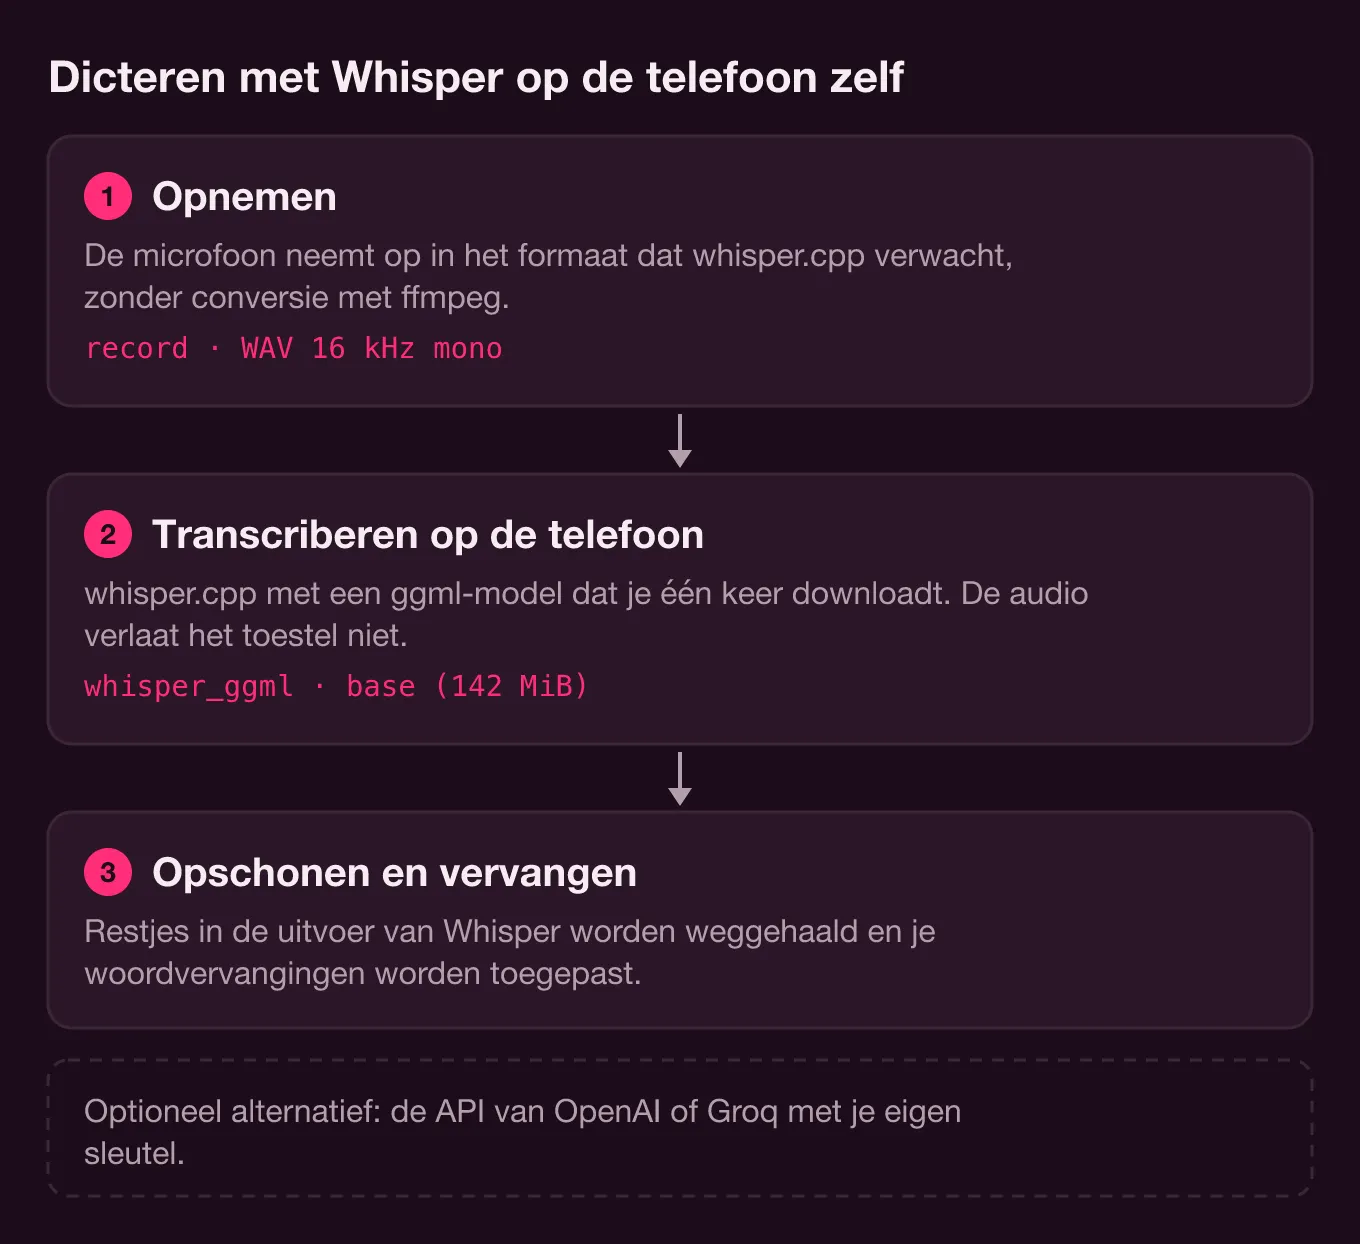
Er is een detail dat je niet meteen ziet. whisper_ggml converteert de invoeraudio met ffmpeg, en ffmpeg alleen daarvoor in een mobiele app stoppen betekent een flinke dependency meeslepen. Omdat Wendo al opneemt in het formaat dat whisper.cpp verwacht, vervangt de pubspec.yaml dat pakket door een lokale stub:
dependency_overrides:
  # whisper_ggml converteert de audio met ffmpeg; Wendo neemt al WAV op in 16 kHz mono (zie het pakket).
  ffmpeg_kit_flutter_new_min:
    path: packages/ffmpeg_kit_stub
De stub (packages/ffmpeg_kit_stub/lib/ffmpeg_kit.dart) implementeert alleen execute, dat altijd “mislukt”. Bij die mislukking transcribeert whisper_ggml het bestand zoals het is. Bouw je Whisper offline in Flutter met dit pakket en neem je zelf al op in WAV van 16 kHz, dan kun je ffmpeg op dezelfde manier kwijtraken.
Welke Whisper-modellen er zijn en hoe groot ze zijn
Wendo levert geen model mee in de app. Er zijn er zeven te kiezen in Instellingen › Spraak, gedefinieerd in WHISPER_MODELS in lib/core/dictation.dart, in twee groepen:
- Meertalig: Tiny (75 MB), Base (142 MB), Small (466 MB) en Turbo, dat is
large-v3-turbo(de app toont het als 1.6 GB). - Alleen Engels:
tiny.en,base.enensmall.en, even groot als hun meertalige versies.
Die groottes kloppen met de officiële modeltabel van whisper.cpp (models/README.md in de repository van ggml-org), die 75 MiB, 142 MiB, 466 MiB en 1,5 GiB voor large-v3-turbo noemt. Het verschil bij Turbo zit in de eenheid: 1,5 GiB is ongeveer 1,6 GB.
De hoofd-README van whisper.cpp geeft ook het geschatte geheugengebruik per grootte: zo’n 273 MB voor tiny, 388 MB voor base en 852 MB voor small. Op een computer maakt dat niets uit. Op een telefoon die ook nog een SSH-sessie, een terminal en misschien een browser open heeft, merk je het.
Welk Whisper-model je op je telefoon gebruikt
De omschrijvingen in de app vatten het samen: Tiny is “snelst, lagere nauwkeurigheid”, Base “snel, goede nauwkeurigheid”, Small “langzamer, uitstekende nauwkeurigheid” en Turbo “hoogste nauwkeurigheid”. Om een agent te dicteren is base een goed beginpunt, en daarom is het de standaard.
De .en-modellen verstaan alleen Engels. Wendo dwingt dat af in de code, dus de taalinstelling heeft er geen invloed op:
// De “.en”-modellen verstaan alleen Engels.
final language = whisperModel.endsWith('.en') ? 'en' : settings.whisperLanguage;
Dicteer je altijd in het Engels, dan zijn ze de moeite waard: de Whisper-repository van OpenAI geeft aan dat de .en-versies beter presteren in het Engels, vooral bij tiny en base. Wissel je van taal, of spreek je Nederlands met Engelse functienamen, gebruik dan een meertalig model met een vaste taal. Automatische detectie (auto) is de standaard, maar bij een dictaat van drie woorden heeft Whisper heel weinig audio om de taal te raden, en een vaste taal haalt die twijfel weg.
Meet de latency op je eigen telefoon
We publiceren geen transcriptietijden, omdat die afhangen van de telefoon, het model en hoe lang je praat. Wendo laat je ze wel meten. In Instellingen › Spraak staat een microfoonknop om de engine te testen, en onder de herkende tekst verschijnt een regel met engine, model, taal, formaat, duur van de audio en de latency in milliseconden. Die komt uit TranscriptionResult, dat bij elke transcriptie durationMs en latencyMs bewaart. Probeer base en small met dezelfde zin en beslis op basis van je eigen cijfers.
Hoe een model gedownload wordt
De modellen komen uit de whisper.cpp-repository op Hugging Face, met de standaard bestandsnaam:
const _hf = 'https://huggingface.co/ggerganov/whisper.cpp/resolve/main';
String _fileName(String id) => 'ggml-$id.bin';
Tik je op een model dat je nog niet hebt, dan downloadt downloadModel het eerst naar een .part-bestand in de tijdelijke map en verplaatst het na afloop naar de documentenmap van de app. Staan die twee mappen op verschillende volumes en lukt hernoemen niet, dan kopieert hij het en verwijdert hij het tijdelijke bestand. Zo gaat een afgebroken download nooit door voor een geldig model.
Toch kan een model beschadigd raken. Als whisper.cpp antwoordt met “failed to load the model”, laat Wendo niet de kale fout zien: hij meldt dat het model beschadigd is en vraagt je het in Instellingen › Spraak te verwijderen en opnieuw te downloaden.
Opnemen in het formaat dat whisper.cpp verwacht
whisper.cpp werkt met 16-bit PCM-WAV op 16 kHz, mono; de README geeft zelfs het ffmpeg-commando om naar dat formaat te converteren. Wendo neemt direct zo op, met record:
const RecordConfig(
  encoder: AudioEncoder.pcm16bits,
  sampleRate: _sampleRate, // 16000
  numChannels: 1,
  androidConfig: AndroidRecordConfig(audioSource: AndroidAudioSource.voiceRecognition),
)
Op Android vraagt hij de bron VOICE_RECOGNITION, die bedoeld is voor spraakherkenning. De PCM-stukjes worden in het geheugen verzameld terwijl je praat. Als je stopt, wacht Wendo 200 ms tot het laatste stukje binnen is en gooit hij opnames korter dan 0,3 seconde weg, want dat zijn meestal per ongeluk aangetikte knoppen. Daarna zet hij er een RIFF-header van 44 bytes voor (encodeWav in lib/components/settings/byok.dart), schrijft dictation.wav naar de cache, transcribeert en verwijdert het bestand in een finally, of het nu goed ging of niet.
Het model blijft geladen tussen dictaten (keepModelLoaded: true), dus alleen het eerste dictaat betaalt de laadtijd. Wissel je van model of verwijder je het model dat in gebruik is, dan geeft Wendo eerst de whisper-context vrij.
Opschonen wat Whisper teruggeeft
Whisper geeft niet altijd gedicteerde tekst terug. Hoort het geen spraak, dan schrijft het markeringen als [BLANK_AUDIO] of zinnetjes tussen haakjes zoals “(stilte)”. In een teksteditor storen die niet; in een terminal belanden ze in de prompt van de agent. _stripNonSpeech haalt weg wat tussen vierkante haken in hoofdletters staat en gooit het hele resultaat weg als het alleen uit een haakjeszin of sterretjes bestaat.
De opgeschoonde tekst gaat naar de Editor of de terminal. Standaard wordt hij ingevoerd zonder op Enter te drukken, zodat je hem kunt nalezen voor je hem verstuurt, tenzij je Automatisch verzenden aanzet. Elk dictaat komt in een lokale geschiedenis (in Instellingen › Spraak › Dictaatgeschiedenis), van waaruit je het opnieuw kunt versturen.
Woordvervangingen
Geen klein model krijgt “tmux”, “kubectl” of de naam van je project goed. Daarvoor zijn woordvervangingen: paren “wat Whisper verstaat” → “wat je bedoelde”. De implementatie past in een paar regels:
// Woordvervangingen: op volgorde, hoofdletterongevoelig, alleen de actieve.
String applyReplacements(String text) {
  var out = text;
  for (final replacement in getSettings().dictationReplacements) {
    if (!replacement.enabled || replacement.from.isEmpty) continue;
    out = out.replaceAllMapped(RegExp(RegExp.escape(replacement.from), caseSensitive: false), (_) => replacement.to);
  }
  return out;
}
Ze worden op volgorde en hoofdletterongevoelig toegepast, je kunt ze uitzetten zonder ze te verwijderen, en als het doel leeg is, verdwijnt het woord. Ze werken hetzelfde met lokale Whisper als met de cloud. Voor de eigennamen uit je werk is een vervanging goedkoper dan overstappen op een groter model.
Het alternatief: je eigen sleutel (OpenAI of Groq)
De BYOK-engine (“bring your own key”) stuurt dezelfde WAV met jouw API-sleutel naar een cloudprovider. Wendo ondersteunt er twee, gedefinieerd in BYOK_PROVIDERS:
- OpenAI, via
/v1/audio/transcriptions, metgpt-4o-mini-transcribeals standaardmodel. - Groq, via zijn OpenAI-compatibele endpoint, met standaard
whisper-large-v3-turbo.
Het modelveld is aan te passen, dus je kunt een ander model invullen dat je provider ondersteunt. De sleutel wordt opgeslagen in de sleutelhanger van het apparaat, één per provider, en de app zegt op hetzelfde scherm dat hij “alleen naar” de gekozen provider wordt verzonden. Het verzoek is een multipart met file, model, response_format: json en, als je automatische detectie niet hebt laten staan, language.
Beide opties bestaan omdat ze iets anders oplossen. Lokale Whisper is privé, werkt zonder bereik en kost niets per dictaat, maar neemt opslag en geheugen in en hangt af van hoe krachtig je telefoon is. De cloud neemt niets in op je telefoon en geeft je grote modellen die er niet op passen, maar de audio verlaat het toestel, je hebt verbinding nodig en je betaalt de provider. Groq draait hetzelfde large-v3-turbo dat Wendo lokaal aanbiedt, alleen op zijn eigen servers in plaats van op je telefoon. OpenAI voegt zijn eigen transcriptiemodellen toe.
Ons advies: begin met base lokaal en een paar vervangingen. Dicteer je veel, heeft je telefoon het zwaar met grote modellen en vind je het geen probleem dat de audio het toestel verlaat, stap dan over op BYOK.
Uitproberen
Dicteren is een onderdeel van Wendo, dat nog niet in de app-stores staat. Je zet het aan met de microfoon in de balk van de terminal of de Editor, of door de knop op het toetsenbord ingedrukt te houden, wat het standaardgebaar is. Heb je je computer nog niet ingericht om vanaf je telefoon met een agent te praten, begin dan bij Claude Code gebruiken vanaf je telefoon, en om de sessie in leven te houden terwijl je dicteert, bij de minimale tmux voor coding agents.