 Lirafy
Whisper en el móvil, sin internet: cómo dicta Wendo
Sí, Whisper funciona en el móvil sin internet. Con whisper.cpp y un modelo ggml descargado una vez, el teléfono transcribe la voz por su cuenta y el audio no sale del dispositivo. Así dicta Wendo, nuestro cliente SSH para seguir agentes como Claude Code desde iOS y Android. Aquí contamos cómo está hecho: qué modelos ofrece, cómo los descarga, en qué formato graba, qué hace con lo que Whisper devuelve y por qué también existe la opción de usar la API de OpenAI o de Groq con tu propia clave.
Whisper sin internet en el móvil: por qué lo usamos
Escribirle a un agente de código desde el teclado del móvil es lento. Las instrucciones para Claude Code suelen ser frases largas («revisa por qué falla el test de login y no toques la migración»), y teclearlas con el pulgar es justo la parte que da pereza. Hablar es más rápido.
El problema es lo que dices. Al dictarle a un agente nombras ficheros, rutas, ramas y a veces cosas del cliente. Mandar ese audio a un servidor ajeno para convertirlo en texto no siempre apetece, y con mala cobertura ni siquiera funciona. Por eso el motor por defecto de Wendo es Whisper en local. En lib/core/settings.dart el valor inicial es speechEngine = 'whisper' con el modelo base, y la pantalla de ajustes lo resume en una línea: «Whisper transcribe en el móvil con whisper.cpp: no se envía audio a ningún servidor».
whisper.cpp en Flutter: whisper_ggml y record
whisper.cpp es la reimplementación en C/C++ de Whisper, el modelo de reconocimiento de voz de OpenAI, que usa el formato de pesos ggml. Corre en CPU sin dependencias pesadas y su repositorio trae ejemplos oficiales para iOS y Android. En Flutter no hay que escribir los bindings a mano: hay varios paquetes en pub.dev que lo envuelven.
Wendo usa dos, según su pubspec.yaml:
record: ^7.1.2
whisper_ggml: ^2.8.1
record graba el micrófono y whisper_ggml llama a whisper.cpp.
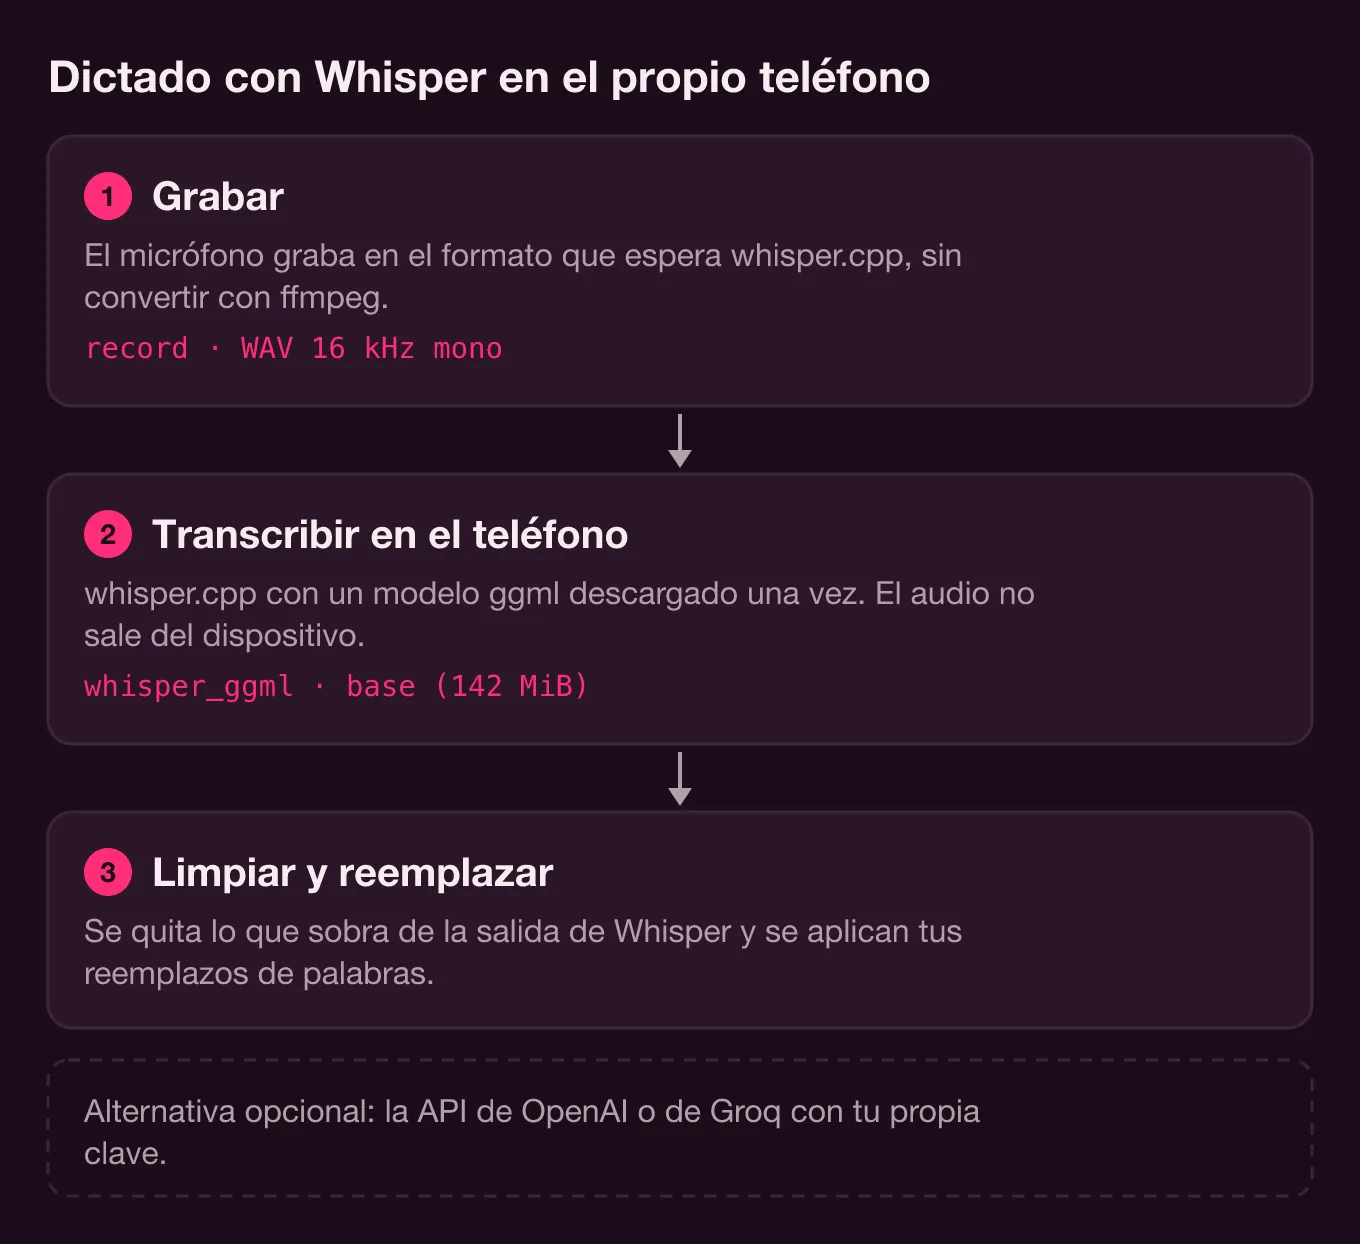
Hay un detalle que no se ve a primera vista. whisper_ggml convierte el audio de entrada con ffmpeg, y meter ffmpeg en una app móvil solo para eso es cargar con una dependencia grande. Como Wendo ya graba en el formato que espera whisper.cpp, el pubspec.yaml sustituye ese paquete por un stub local:
dependency_overrides:
  # whisper_ggml convierte el audio con ffmpeg; Wendo ya graba WAV de 16 kHz mono (ver el paquete).
  ffmpeg_kit_flutter_new_min:
    path: packages/ffmpeg_kit_stub
El stub (packages/ffmpeg_kit_stub/lib/ffmpeg_kit.dart) implementa solo execute, que siempre «falla». Ante ese fallo, whisper_ggml transcribe el archivo tal cual. Si montas Whisper offline en Flutter con este paquete y la grabación ya la haces tú en WAV de 16 kHz, puedes quitarte ffmpeg de encima de la misma forma.
Qué modelos de Whisper ofrece y cuánto ocupan
Wendo no lleva ningún modelo dentro de la app. Ofrece siete en Ajustes › Voz, definidos en WHISPER_MODELS de lib/core/dictation.dart, en dos grupos:
- Multilingües: Tiny (75 MB), Base (142 MB), Small (466 MB) y Turbo, que es
large-v3-turbo(la app lo muestra como 1.6 GB). - Solo inglés:
tiny.en,base.enysmall.en, con los mismos tamaños que sus versiones multilingües.
Esos tamaños coinciden con la tabla oficial de modelos de whisper.cpp (models/README.md en el repositorio de ggml-org), que da 75 MiB, 142 MiB, 466 MiB y 1,5 GiB para large-v3-turbo. La diferencia del Turbo es de unidades: 1,5 GiB son unos 1,6 GB.
El README principal de whisper.cpp también publica la memoria aproximada que usa cada tamaño: unos 273 MB el tiny, 388 MB el base y 852 MB el small. En un ordenador da igual. En un teléfono que además tiene abierta una sesión SSH, un terminal y quizá un navegador, se nota.
Qué modelo de Whisper usar en el móvil
Las descripciones de la propia app lo resumen: Tiny es «el más rápido, menor precisión», Base es «rápido, buena precisión», Small es «más lento, excelente precisión» y Turbo, «máxima precisión». Para dictarle a un agente, base es un buen punto de partida, y por eso es el valor por defecto.
Los modelos .en solo entienden inglés. Wendo lo fuerza en el código, así que el ajuste de idioma no les afecta:
// Los modelos «.en» solo entienden inglés.
final language = whisperModel.endsWith('.en') ? 'en' : settings.whisperLanguage;
Si dictas siempre en inglés, compensan: el repositorio de Whisper de OpenAI indica que las versiones .en rinden mejor en inglés, sobre todo en los tamaños tiny y base. Si mezclas idiomas, o hablas en español con nombres de funciones en inglés, usa un multilingüe con el idioma fijado. La detección automática (auto) es el valor por defecto, pero en un dictado de tres palabras Whisper tiene muy poco audio para adivinar el idioma, y fijarlo te quita esa duda.
Mide la latencia en tu teléfono
No publicamos tiempos de transcripción porque dependen del teléfono, del modelo y de lo que dures hablando. Lo que hace Wendo es dejarte medirlo. En Ajustes › Voz hay un botón de micrófono para probar el motor, y bajo el texto reconocido aparece una línea con el motor, el modelo, el idioma, el formato, la duración del audio y la latencia en milisegundos. Sale de TranscriptionResult, que guarda durationMs y latencyMs en cada transcripción. Prueba base y small con la misma frase y decide con tus números.
Cómo se descarga un modelo
Los modelos salen del repositorio de whisper.cpp en Hugging Face, con el nombre de fichero estándar:
const _hf = 'https://huggingface.co/ggerganov/whisper.cpp/resolve/main';
String _fileName(String id) => 'ggml-$id.bin';
Al tocar un modelo que no tienes, downloadModel lo baja primero a un fichero .part en la carpeta temporal y, cuando termina, lo mueve a la carpeta de documentos de la app. Si las dos carpetas están en volúmenes distintos y no se puede renombrar, lo copia y borra el temporal. Así una descarga cortada nunca pasa por un modelo válido.
Aun así, un modelo puede acabar dañado. Cuando whisper.cpp responde «failed to load the model», Wendo no enseña el error crudo: avisa de que el modelo está dañado y te pide borrarlo en Ajustes › Voz y descargarlo de nuevo.
Grabar en el formato que espera whisper.cpp
whisper.cpp trabaja con WAV PCM de 16 bits a 16 kHz y mono; su README da incluso el comando de ffmpeg para convertir a ese formato. Wendo graba directamente así, con record:
const RecordConfig(
  encoder: AudioEncoder.pcm16bits,
  sampleRate: _sampleRate, // 16000
  numChannels: 1,
  androidConfig: AndroidRecordConfig(audioSource: AndroidAudioSource.voiceRecognition),
)
En Android pide la fuente VOICE_RECOGNITION, pensada para reconocimiento de voz. Los trozos de PCM se acumulan en memoria mientras hablas. Al parar, Wendo espera 200 ms a que llegue el último trozo y descarta grabaciones de menos de 0,3 segundos, que suelen ser toques sin querer. Después antepone una cabecera RIFF de 44 bytes (encodeWav en lib/components/settings/byok.dart), escribe dictation.wav en la caché, transcribe y borra el fichero en un finally, haya ido bien o mal.
El modelo se queda cargado entre dictados (keepModelLoaded: true), así que solo el primero paga el coste de cargarlo. Si cambias de modelo o borras el que está en uso, Wendo libera antes el contexto de whisper.
Limpiar lo que devuelve Whisper
Whisper no devuelve siempre texto dictado. Cuando no oye voz, escribe marcas como [BLANK_AUDIO] o frases entre paréntesis del estilo «(silencio)». En un editor no molestan; en un terminal acaban en el prompt del agente. _stripNonSpeech quita lo que va entre corchetes en mayúsculas y descarta el resultado entero si es solo un paréntesis o asteriscos.
El texto limpio va al redactor o al terminal. Por defecto se escribe sin pulsar Enter, para que lo revises antes de mandarlo, salvo que actives Envío automático. Cada dictado queda en un historial local (en Ajustes › Voz › Historial de dictado) desde el que puedes reenviarlo.
Reemplazos de palabras
Ningún modelo pequeño acierta con «tmux», «kubectl» o el nombre de tu proyecto. Para eso están los reemplazos de palabras: pares «lo que entiende Whisper» → «lo que querías decir». La implementación cabe en unas líneas:
// Reemplazos de palabras: en orden, sin distinguir mayúsculas, solo los activos.
String applyReplacements(String text) {
  var out = text;
  for (final replacement in getSettings().dictationReplacements) {
    if (!replacement.enabled || replacement.from.isEmpty) continue;
    out = out.replaceAllMapped(RegExp(RegExp.escape(replacement.from), caseSensitive: false), (_) => replacement.to);
  }
  return out;
}
Se aplican en orden y sin distinguir mayúsculas, se pueden desactivar sin borrarlos y, si el destino está vacío, la palabra se elimina. Funcionan igual con Whisper local y con la nube. Para los nombres propios de tu trabajo, un reemplazo sale más barato que pasar a un modelo más grande.
La alternativa: trae tu propia clave (OpenAI o Groq)
El motor BYOK («bring your own key») sube el mismo WAV a un proveedor en la nube con tu clave de API. Wendo admite dos, definidos en BYOK_PROVIDERS:
- OpenAI, contra
/v1/audio/transcriptions, congpt-4o-mini-transcribecomo modelo por defecto. - Groq, contra su endpoint compatible con OpenAI, con
whisper-large-v3-turbopor defecto.
El campo del modelo es editable, así que puedes poner otro que admita tu proveedor. La clave se guarda en el llavero del dispositivo, una por proveedor, y la app dice en la misma pantalla que «solo se envía» al proveedor elegido. La petición es un multipart con file, model, response_format: json y, si no has dejado la detección automática, language.
Existen las dos opciones porque resuelven cosas distintas. Whisper local es privado, funciona sin cobertura y no cuesta nada por dictado, a cambio de ocupar espacio y memoria y de depender de la potencia del teléfono. La nube no ocupa nada en el móvil y te da modelos grandes que no caben en él, pero el audio sale del dispositivo, necesitas conexión y pagas al proveedor. Groq sirve el mismo large-v3-turbo que Wendo ofrece en local, con la diferencia de que lo ejecuta en sus servidores y no en tu teléfono. OpenAI añade sus modelos de transcripción propios.
Nuestra recomendación: empieza con base en local y unos cuantos reemplazos. Si dictas mucho, el teléfono va justo con modelos grandes y no te importa que el audio salga del móvil, pasa a BYOK.
Probarlo
El dictado es una parte de Wendo, que todavía no está en las tiendas. Se activa con el micrófono de la barra del terminal o del redactor, o manteniendo pulsado el botón del teclado, que es el gesto que viene por defecto. Si aún no tienes montado el ordenador para hablar con un agente desde el móvil, empieza por cómo usar Claude Code desde el móvil, y para que la sesión siga viva mientras dictas, el tmux mínimo para agentes de código.