 Lirafy
Whisper hors ligne sur le téléphone : comment Wendo fait la dictée
Oui, Whisper hors ligne fonctionne sur un téléphone. Avec whisper.cpp et un modèle ggml téléchargé une fois, le téléphone transcrit la voix tout seul et l’audio ne quitte pas l’appareil. C’est comme ça que dicte Wendo, notre client SSH pour suivre des agents comme Claude Code depuis iOS et Android.
Nous racontons ici comment c’est fait : quels modèles il propose, comment il les télécharge, dans quel format il enregistre, ce qu’il fait de ce que renvoie Whisper et pourquoi il existe aussi l’option d’utiliser l’API d’OpenAI ou de Groq avec ta propre clé.
Whisper hors ligne sur le téléphone : pourquoi nous l’utilisons
Écrire à un agent de code sur le clavier du téléphone, c’est lent. Les instructions pour Claude Code sont souvent de longues phrases (« regarde pourquoi le test de login échoue et ne touche pas à la migration »), et les taper au pouce, c’est justement la partie pénible. Parler va plus vite.
Le problème, c’est ce que tu dis. En dictant à un agent, tu cites des fichiers, des chemins, des branches et parfois des choses qui appartiennent à un client. Envoyer cet audio à un serveur tiers pour le transformer en texte, on n’en a pas toujours envie, et avec une mauvaise couverture ça ne marche même pas. Le moteur par défaut de Wendo est donc Whisper en local. Dans lib/core/settings.dart, la valeur initiale est speechEngine = 'whisper' avec le modèle base, et l’écran des réglages le résume en une ligne : « Whisper transcrit sur le téléphone avec whisper.cpp : aucun audio n’est envoyé à un serveur. »
whisper.cpp en Flutter : whisper_ggml et record
whisper.cpp est la réimplémentation en C/C++ de Whisper, le modèle de reconnaissance vocale d’OpenAI, et utilise le format de poids ggml. Il tourne sur le CPU sans dépendances lourdes, et son dépôt fournit des exemples officiels pour iOS et Android. En Flutter, pas besoin d’écrire les bindings à la main : plusieurs paquets sur pub.dev l’enveloppent.
Wendo en utilise deux, d’après son pubspec.yaml :
record: ^7.1.2
whisper_ggml: ^2.8.1
record enregistre le micro et whisper_ggml appelle whisper.cpp.
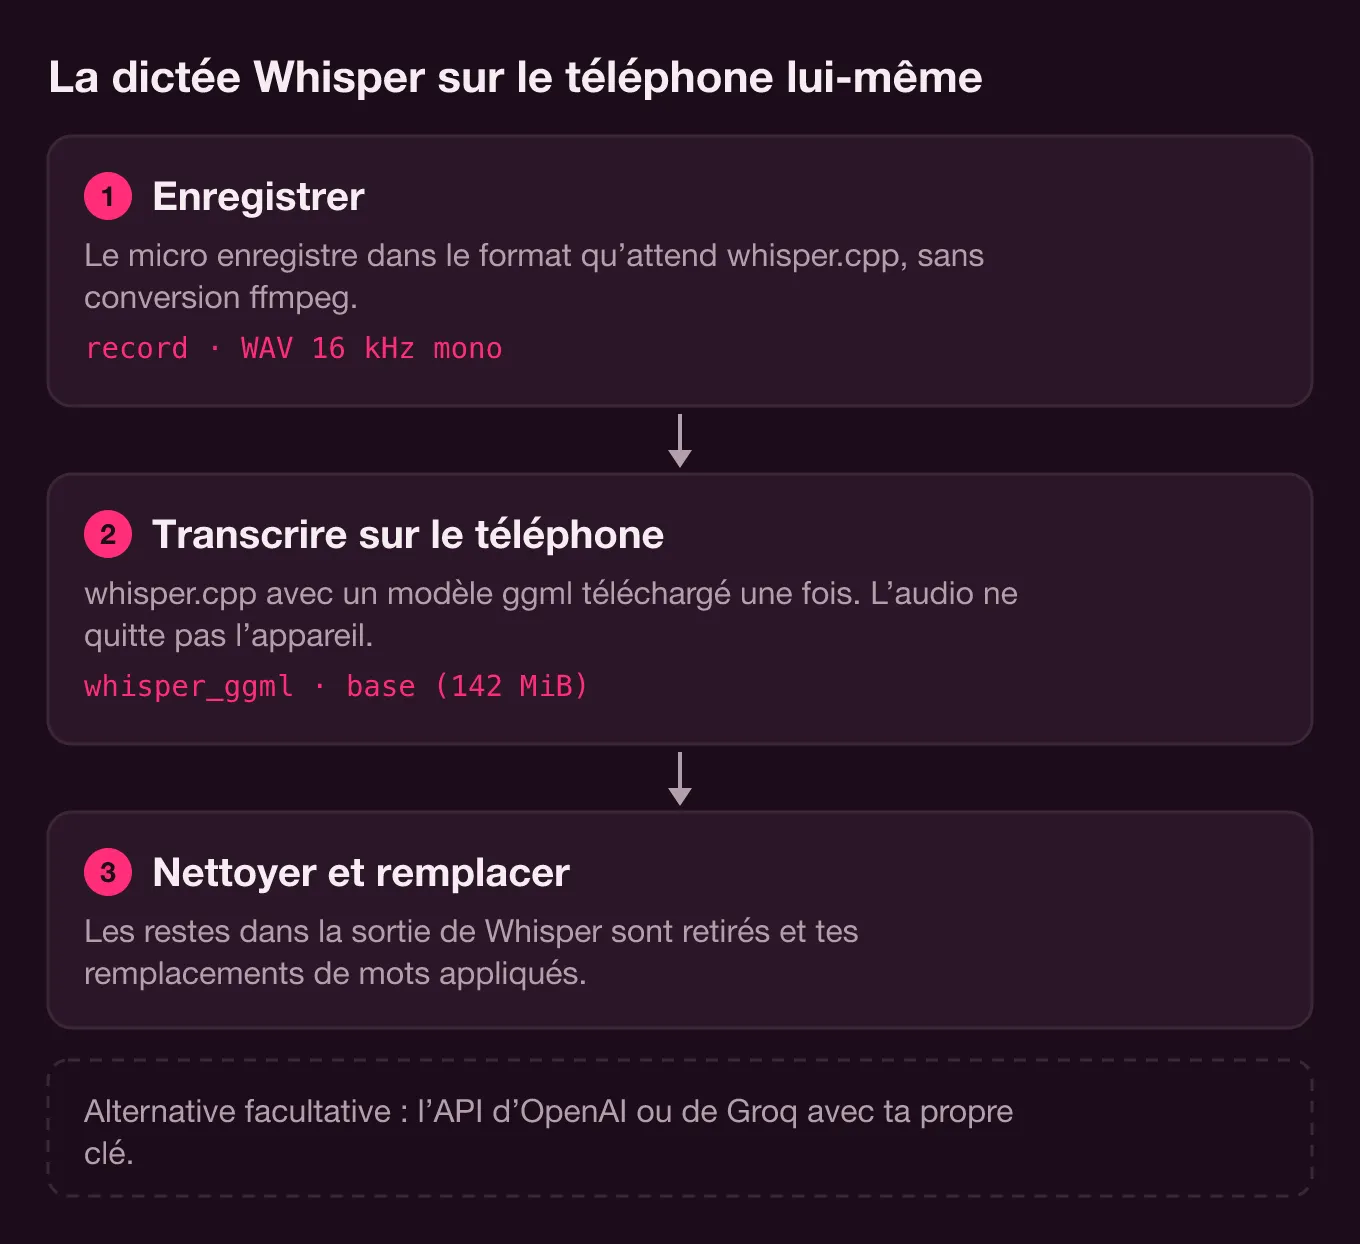
Un détail ne se voit pas tout de suite. whisper_ggml convertit l’audio d’entrée avec ffmpeg, et embarquer ffmpeg dans une app mobile rien que pour ça, c’est traîner une grosse dépendance. Comme Wendo enregistre déjà dans le format qu’attend whisper.cpp, le pubspec.yaml remplace ce paquet par un stub local :
dependency_overrides:
  # whisper_ggml convertit l’audio avec ffmpeg ; Wendo enregistre déjà du WAV 16 kHz mono (voir le paquet).
  ffmpeg_kit_flutter_new_min:
    path: packages/ffmpeg_kit_stub
Le stub (packages/ffmpeg_kit_stub/lib/ffmpeg_kit.dart) n’implémente que execute, qui « échoue » toujours. Face à cet échec, whisper_ggml transcrit le fichier tel quel. Si tu montes Whisper hors ligne dans Flutter avec ce paquet et que tu enregistres déjà toi-même en WAV 16 kHz, tu peux te débarrasser de ffmpeg de la même façon.
Quels modèles Whisper sont proposés et combien ils pèsent
Wendo n’embarque aucun modèle dans l’app. Il en propose sept dans Réglages › Voix, définis dans WHISPER_MODELS de lib/core/dictation.dart, en deux groupes :
- Multilingues : Tiny (75 Mo), Base (142 Mo), Small (466 Mo) et Turbo, c’est-à-dire
large-v3-turbo(l’app l’affiche à 1.6 GB). - Anglais seulement :
tiny.en,base.enetsmall.en, avec les mêmes tailles que leurs versions multilingues.
Ces tailles correspondent au tableau officiel des modèles de whisper.cpp (models/README.md dans le dépôt de ggml-org), qui indique 75 MiB, 142 MiB, 466 MiB et 1,5 GiB pour large-v3-turbo. L’écart du Turbo n’est qu’une question d’unités : 1,5 GiB font environ 1,6 Go.
Le README principal de whisper.cpp publie aussi la mémoire approximative utilisée par chaque taille : environ 273 Mo pour tiny, 388 Mo pour base et 852 Mo pour small. Sur un ordinateur, peu importe. Sur un téléphone qui a aussi une session SSH, un terminal et peut-être un navigateur ouverts, ça se sent.
Quel modèle Whisper utiliser sur un téléphone
Les descriptions de l’app le résument : Tiny, c’est « Le plus rapide, précision moindre », Base « Rapide, bonne précision », Small « Plus lent, excellente précision » et Turbo « Précision maximale ». Pour dicter à un agent, base est un bon point de départ, et c’est pour ça que c’est la valeur par défaut.
Les modèles .en ne comprennent que l’anglais. Wendo l’impose dans le code, donc le réglage de langue ne les affecte pas :
// Les modèles « .en » ne comprennent que l’anglais.
final language = whisperModel.endsWith('.en') ? 'en' : settings.whisperLanguage;
Si tu dictes toujours en anglais, ils valent le coup : le dépôt Whisper d’OpenAI indique que les versions .en sont meilleures en anglais, surtout pour les tailles tiny et base. Si tu mélanges les langues, ou si tu parles français avec des noms de fonctions en anglais, prends un multilingue avec la langue fixée. La détection automatique (auto) est la valeur par défaut, mais sur une dictée de trois mots, Whisper a très peu d’audio pour deviner la langue, et la fixer t’enlève ce doute.
Mesure la latence sur ton téléphone
Nous ne publions pas de temps de transcription, parce qu’ils dépendent du téléphone, du modèle et de la durée pendant laquelle tu parles. Wendo te laisse plutôt le mesurer. Dans Réglages › Voix, un bouton micro permet de tester le moteur, et sous le texte reconnu apparaît une ligne avec le moteur, le modèle, la langue, le format, la durée de l’audio et la latence en millisecondes. Elle vient de TranscriptionResult, qui garde durationMs et latencyMs à chaque transcription. Essaie base et small avec la même phrase et décide avec tes propres chiffres.
Comment un modèle se télécharge
Les modèles viennent du dépôt whisper.cpp sur Hugging Face, avec le nom de fichier standard :
const _hf = 'https://huggingface.co/ggerganov/whisper.cpp/resolve/main';
String _fileName(String id) => 'ggml-$id.bin';
Quand tu touches un modèle que tu n’as pas, downloadModel le télécharge d’abord dans un fichier .part du dossier temporaire puis, une fois terminé, le déplace dans le dossier documents de l’app. Si les deux dossiers sont sur des volumes différents et que le renommage échoue, il le copie et supprime le temporaire. Ainsi, un téléchargement interrompu ne passe jamais pour un modèle valide.
Un modèle peut quand même finir abîmé. Quand whisper.cpp répond « failed to load the model », Wendo n’affiche pas l’erreur brute : il signale que le modèle est endommagé et te demande de le supprimer dans Réglages › Voix puis de le retélécharger.
Enregistrer dans le format qu’attend whisper.cpp
whisper.cpp travaille avec du WAV PCM 16 bits à 16 kHz, en mono ; son README donne même la commande ffmpeg pour convertir dans ce format. Wendo enregistre directement ainsi, avec record :
const RecordConfig(
  encoder: AudioEncoder.pcm16bits,
  sampleRate: _sampleRate, // 16000
  numChannels: 1,
  androidConfig: AndroidRecordConfig(audioSource: AndroidAudioSource.voiceRecognition),
)
Sur Android, il demande la source VOICE_RECOGNITION, prévue pour la reconnaissance vocale. Les morceaux de PCM s’accumulent en mémoire pendant que tu parles. À l’arrêt, Wendo attend 200 ms que le dernier morceau arrive et jette les enregistrements de moins de 0,3 seconde, qui sont en général des touches involontaires. Ensuite, il ajoute devant un en-tête RIFF de 44 octets (encodeWav dans lib/components/settings/byok.dart), écrit dictation.wav dans le cache, transcrit et supprime le fichier dans un finally, que ça se soit bien passé ou non.
Le modèle reste chargé entre deux dictées (keepModelLoaded: true), donc seule la première paie le coût du chargement. Si tu changes de modèle ou supprimes celui en cours d’utilisation, Wendo libère d’abord le contexte whisper.
Nettoyer ce que renvoie Whisper
Whisper ne renvoie pas toujours du texte dicté. Quand il n’entend pas de voix, il écrit des marqueurs comme [BLANK_AUDIO] ou des phrases entre parenthèses du genre « (silence) ». Dans un éditeur, ça ne gêne pas ; dans un terminal, ça finit dans le prompt de l’agent. _stripNonSpeech retire ce qui est entre crochets en majuscules et jette tout le résultat s’il ne contient qu’une parenthèse ou des astérisques.
Le texte nettoyé va dans l’éditeur ou dans le terminal. Par défaut, il est saisi sans appuyer sur Entrée, pour que tu le relises avant de l’envoyer, sauf si tu actives Envoi auto. Chaque dictée reste dans un historique local (dans Réglages › Voix › Historique de dictée) d’où tu peux la renvoyer.
Remplacements de mots
Aucun petit modèle ne réussit « tmux », « kubectl » ou le nom de ton projet. C’est à ça que servent les remplacements de mots : des paires « ce que Whisper a compris » → « ce que tu voulais dire ». L’implémentation tient en quelques lignes :
// Remplacements de mots : dans l’ordre, sans tenir compte de la casse, seulement les actifs.
String applyReplacements(String text) {
  var out = text;
  for (final replacement in getSettings().dictationReplacements) {
    if (!replacement.enabled || replacement.from.isEmpty) continue;
    out = out.replaceAllMapped(RegExp(RegExp.escape(replacement.from), caseSensitive: false), (_) => replacement.to);
  }
  return out;
}
Ils s’appliquent dans l’ordre et sans tenir compte de la casse, on peut les désactiver sans les supprimer et, si la cible est vide, le mot est supprimé. Ils marchent pareil avec Whisper en local et avec le cloud. Pour les noms propres de ton travail, un remplacement coûte moins cher que de passer à un modèle plus gros.
L’alternative : ta propre clé (OpenAI ou Groq)
Le moteur BYOK (« bring your own key ») envoie le même WAV à un fournisseur cloud avec ta clé d’API. Wendo en prend en charge deux, définis dans BYOK_PROVIDERS :
- OpenAI, sur
/v1/audio/transcriptions, avecgpt-4o-mini-transcribecomme modèle par défaut. - Groq, sur son endpoint compatible OpenAI, avec
whisper-large-v3-turbopar défaut.
Le champ du modèle est modifiable, tu peux donc en mettre un autre que ton fournisseur accepte. La clé est stockée dans le trousseau de l’appareil, une par fournisseur, et l’app indique sur le même écran qu’elle est « envoyée uniquement » au fournisseur choisi. La requête est un multipart avec file, model, response_format: json et, si tu n’as pas laissé la détection automatique, language.
Les deux options existent parce qu’elles règlent des problèmes différents. Whisper en local est privé, fonctionne sans couverture et ne coûte rien par dictée, en échange de place et de mémoire, et il dépend de la puissance du téléphone. Le cloud n’occupe rien sur le téléphone et te donne de gros modèles qui n’y tiennent pas, mais l’audio quitte l’appareil, il te faut une connexion et tu paies le fournisseur. Groq sert le même large-v3-turbo que Wendo propose en local, à ceci près qu’il le fait tourner sur ses serveurs et pas sur ton téléphone. OpenAI ajoute ses propres modèles de transcription.
Notre conseil : commence avec base en local et quelques remplacements. Si tu dictes beaucoup, que ton téléphone peine avec les gros modèles et que ça ne te gêne pas que l’audio sorte de l’appareil, passe au BYOK.
L’essayer
La dictée est une partie de Wendo, qui n’est pas encore sur les stores. Elle se lance avec le micro de la barre du terminal ou de l’éditeur, ou en maintenant appuyé le bouton du clavier, le geste par défaut. Si ton ordinateur n’est pas encore prêt pour parler à un agent depuis ton téléphone, commence par utiliser Claude Code depuis ton téléphone, et pour que la session reste en vie pendant que tu dictes, le tmux minimal pour les agents de code.