 Lirafy
Whisper на телефоні без інтернету: як диктує Wendo
Так, Whisper працює на телефоні без інтернету. З whisper.cpp і моделлю ggml, яку завантажують один раз, телефон сам перетворює голос на текст, і аудіо не залишає пристрою. Так диктує Wendo, наш SSH-клієнт для iOS і Android, з якого стежать за агентами на кшталт Claude Code. Тут розповідаємо, як це зроблено: які моделі ми пропонуємо, як вони завантажуються, у якому форматі ми записуємо, що робимо з тим, що повертає Whisper, і навіщо є ще варіант з API OpenAI або Groq і вашим власним ключем.
Whisper без інтернету на телефоні: навіщо він нам
Писати агентові коду з клавіатури телефона повільно. Інструкції для Claude Code зазвичай довгі («подивись, чому падає тест логіну, і не чіпай міграцію»), і саме їх найменше хочеться набирати великим пальцем. Говорити швидше.
Проблема в тому, що ви кажете. Диктуючи агентові, ви називаєте файли, шляхи, гілки, а часом і речі клієнта. Відправляти такий запис на чужий сервер, щоб отримати текст, хочеться не завжди, а з поганим зв’язком це й не працює. Тому типовий рушій у Wendo — локальний Whisper. У lib/core/settings.dart початкове значення speechEngine = 'whisper' з моделлю base, а екран налаштувань пояснює це одним рядком: «Whisper розпізнає мовлення на телефоні через whisper.cpp: аудіо не надсилається на жоден сервер».
whisper.cpp у Flutter: whisper_ggml і record
whisper.cpp є реалізацією Whisper, моделі розпізнавання мовлення від OpenAI, на C/C++, і використовує формат ваг ggml. Він працює на CPU без важких залежностей, а в його репозиторії є офіційні приклади для iOS і Android. У Flutter не треба писати біндинги вручну: на pub.dev є кілька пакетів-обгорток.
Wendo використовує два, згідно з pubspec.yaml:
record: ^7.1.2
whisper_ggml: ^2.8.1
record записує мікрофон, а whisper_ggml викликає whisper.cpp.
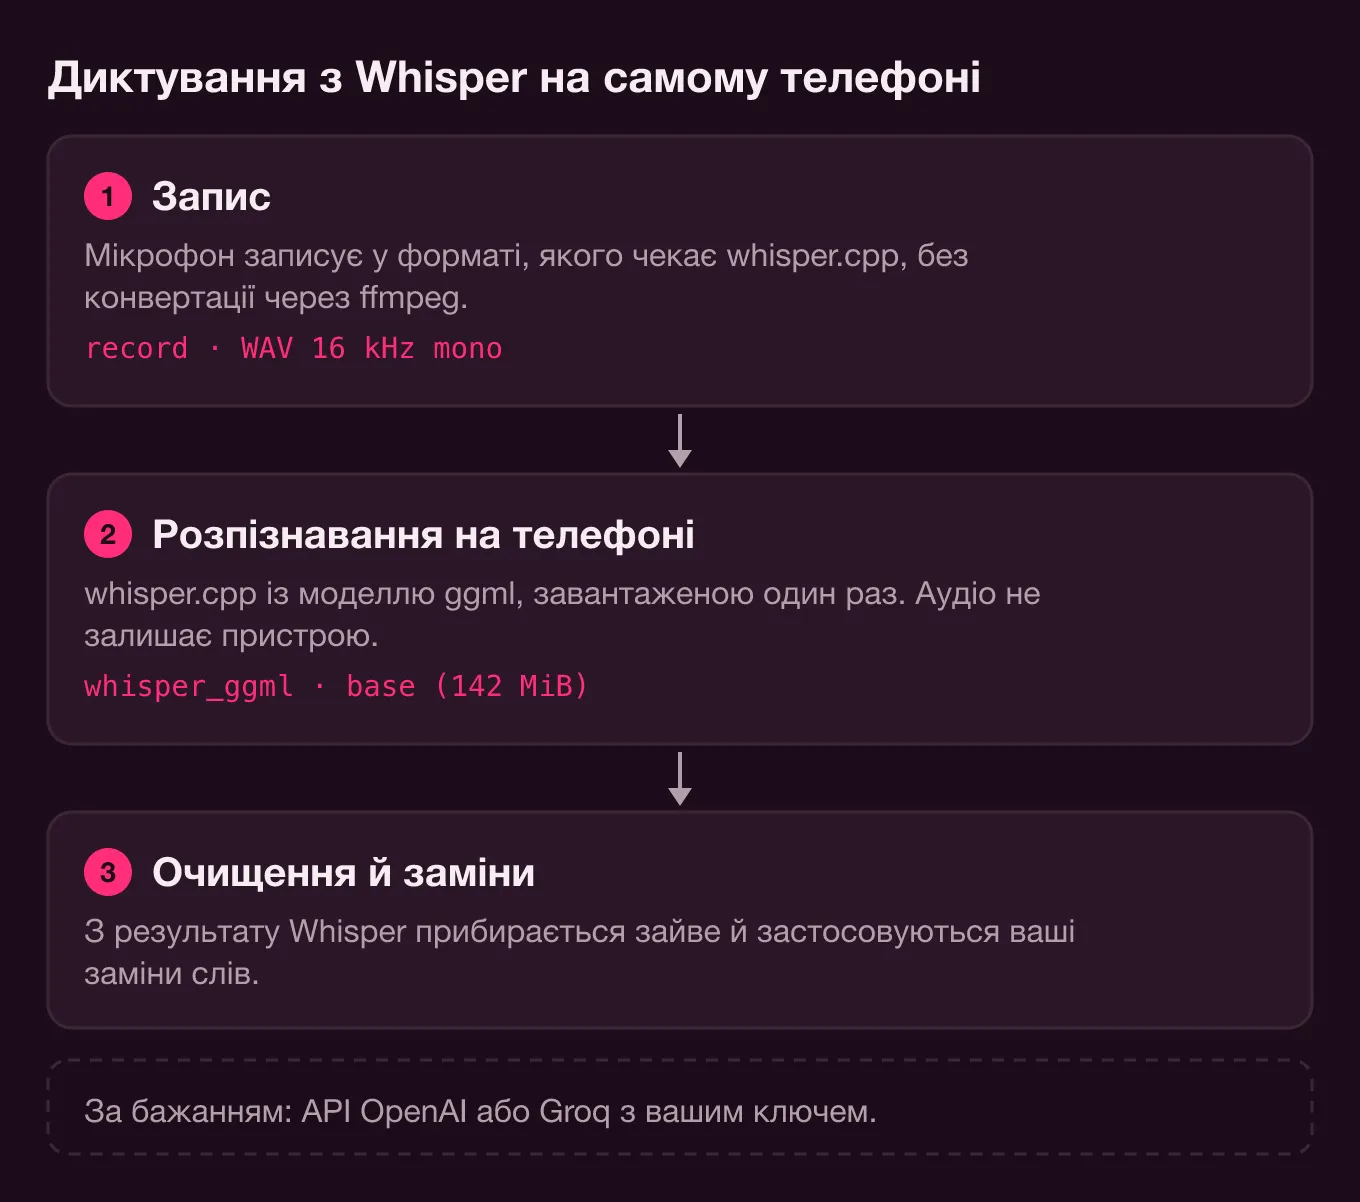
Є деталь, яку не видно одразу. whisper_ggml перетворює вхідне аудіо через ffmpeg, а тягнути ffmpeg у мобільний застосунок лише заради цього означає носити велику залежність. Wendo вже записує у форматі, якого чекає whisper.cpp, тому pubspec.yaml підміняє цей пакет локальною заглушкою:
dependency_overrides:
  # whisper_ggml перетворює аудіо через ffmpeg; Wendo вже записує WAV 16 кГц моно (див. пакет).
  ffmpeg_kit_flutter_new_min:
    path: packages/ffmpeg_kit_stub
Заглушка (packages/ffmpeg_kit_stub/lib/ffmpeg_kit.dart) реалізує лише execute, який завжди «падає». Отримавши цю помилку, whisper_ggml розпізнає файл як є. Якщо ви збираєте офлайн-Whisper у Flutter на цьому пакеті й самі записуєте WAV 16 кГц, так само можна позбутися ffmpeg.
Які моделі Whisper є і скільки вони займають
Wendo не вшиває жодної моделі в застосунок. У розділі «Налаштування › Мовлення» їх сім, вони описані в WHISPER_MODELS у lib/core/dictation.dart і поділені на дві групи:
- Багатомовні: Tiny (75 MB), Base (142 MB), Small (466 MB) і Turbo, тобто
large-v3-turbo(застосунок показує 1.6 GB). - Лише англійська:
tiny.en,base.enіsmall.en, з тими самими розмірами, що й багатомовні версії.
Ці розміри збігаються з офіційною таблицею моделей whisper.cpp (models/README.md у репозиторії ggml-org), де вказано 75 MiB, 142 MiB, 466 MiB і 1,5 GiB для large-v3-turbo. Різниця в Turbo тільки в одиницях: 1,5 GiB це приблизно 1,6 GB.
Головний README whisper.cpp також наводить приблизний обсяг пам’яті для кожного розміру: близько 273 MB для tiny, 388 MB для base і 852 MB для small. На комп’ютері це байдуже. На телефоні, де водночас відкриті сесія SSH, термінал і, може, браузер, це відчутно.
Яку модель Whisper вибрати для телефона
Описи в самому застосунку все підсумовують: Tiny «Найшвидша, нижча точність», Base «Швидка, добра точність», Small «Повільніше, чудова точність», Turbo «Найвища точність». Для диктування агентові base є добрим стартом, тому вона й стоїть за замовчуванням.
Моделі .en розуміють тільки англійську. Wendo примусово задає це в коді, тож налаштування мови на них не впливає:
// Моделі «.en» розуміють тільки англійську.
final language = whisperModel.endsWith('.en') ? 'en' : settings.whisperLanguage;
Якщо ви завжди диктуєте англійською, вони того варті: у репозиторії Whisper від OpenAI сказано, що версії .en дають кращий результат англійською, особливо в розмірах tiny і base. Якщо ви змішуєте мови або говорите українською з назвами функцій англійською, беріть багатомовну модель із зафіксованою мовою. Автовизначення (auto) стоїть за замовчуванням, але в диктовці з трьох слів у Whisper замало аудіо, щоб вгадати мову, і фіксована мова знімає це питання.
Поміряйте затримку на своєму телефоні
Ми не публікуємо час розпізнавання, бо він залежить від телефона, моделі й того, скільки ви говорите. Натомість Wendo дає поміряти його самим. У «Налаштування › Мовлення» є кнопка мікрофона для перевірки рушія, а під розпізнаним текстом з’являється рядок із рушієм, моделлю, мовою, форматом, тривалістю аудіо та затримкою в мілісекундах. Дані беруться з TranscriptionResult, який зберігає durationMs і latencyMs для кожного розпізнавання. Спробуйте base і small з тією самою фразою і вирішуйте за своїми цифрами.
Як завантажується модель
Моделі беруться з репозиторію whisper.cpp на Hugging Face зі стандартною назвою файла:
const _hf = 'https://huggingface.co/ggerganov/whisper.cpp/resolve/main';
String _fileName(String id) => 'ggml-$id.bin';
Коли ви торкаєтеся моделі, якої ще немає, downloadModel спершу завантажує її у файл .part у тимчасовій теці, а після завершення переносить у теку документів застосунку. Якщо теки на різних томах і перейменувати не вдається, файл копіюється, а тимчасовий видаляється. Тож обірване завантаження ніколи не видаватиметься за робочу модель.
Модель однаково може пошкодитися. Коли whisper.cpp відповідає «failed to load the model», Wendo не показує сиру помилку: він повідомляє, що модель пошкоджена, і просить видалити її в «Налаштування › Мовлення» та завантажити знову.
Запис у форматі, якого чекає whisper.cpp
whisper.cpp працює з WAV PCM 16 біт, 16 кГц, моно; його README навіть дає команду ffmpeg для конвертації в цей формат. Wendo одразу записує так через record:
const RecordConfig(
  encoder: AudioEncoder.pcm16bits,
  sampleRate: _sampleRate, // 16000
  numChannels: 1,
  androidConfig: AndroidRecordConfig(audioSource: AndroidAudioSource.voiceRecognition),
)
На Android застосунок просить джерело VOICE_RECOGNITION, створене саме для розпізнавання мовлення. Шматки PCM накопичуються в пам’яті, поки ви говорите. Коли ви зупиняєтеся, Wendo чекає 200 мс на останній шматок і відкидає записи коротші за 0,3 секунди, бо це зазвичай випадкові дотики. Потім додає попереду 44-байтовий заголовок RIFF (encodeWav у lib/components/settings/byok.dart), пише dictation.wav у кеш, розпізнає і видаляє файл у finally, хоч би як усе пройшло.
Модель лишається завантаженою між диктовками (keepModelLoaded: true), тож платити за її завантаження доводиться лише першій. Якщо ви міняєте модель або видаляєте ту, що зараз використовується, Wendo спершу звільняє контекст whisper.
Прибрати зайве з того, що повертає Whisper
Whisper не завжди повертає продиктований текст. Коли він не чує голосу, то пише позначки на кшталт [BLANK_AUDIO] або фрази в дужках типу «(тиша)». У редакторі вони не заважають, а в терміналі потрапляють у запрошення агента. _stripNonSpeech прибирає те, що стоїть у квадратних дужках великими літерами, і відкидає весь результат, якщо там тільки дужки або зірочки.
Очищений текст іде в редактор або в термінал. За замовчуванням він вставляється без Enter, щоб ви перевірили його перед відправкою, якщо тільки не ввімкнено Автонадсилання. Кожна диктовка лягає в локальну історію («Налаштування › Мовлення › Історія диктовки»), звідки її можна надіслати ще раз.
Заміни слів
Жодна маленька модель не впорається з «tmux», «kubectl» чи назвою вашого проєкту. Для цього є заміни слів: пари «що почув Whisper» → «що ви мали на увазі». Реалізація вміщається в кілька рядків:
// Заміни слів: по черзі, без урахування регістру, лише активні.
String applyReplacements(String text) {
  var out = text;
  for (final replacement in getSettings().dictationReplacements) {
    if (!replacement.enabled || replacement.from.isEmpty) continue;
    out = out.replaceAllMapped(RegExp(RegExp.escape(replacement.from), caseSensitive: false), (_) => replacement.to);
  }
  return out;
}
Вони застосовуються по черзі й без урахування регістру, їх можна вимкнути, не видаляючи, а якщо ціль порожня, слово просто зникає. Працюють однаково з локальним Whisper і з хмарою. Для власних назв із вашої роботи заміна обійдеться дешевше, ніж перехід на більшу модель.
Альтернатива: власний ключ (OpenAI або Groq)
Рушій BYOK («bring your own key») відправляє той самий WAV хмарному провайдерові з вашим ключем API. Wendo підтримує двох, вони описані в BYOK_PROVIDERS:
- OpenAI, через
/v1/audio/transcriptions, зgpt-4o-mini-transcribeяк моделлю за замовчуванням. - Groq, через його ендпойнт, сумісний з OpenAI, з
whisper-large-v3-turboза замовчуванням.
Поле моделі можна редагувати, тож туди можна вписати іншу, яку підтримує ваш провайдер. Ключ зберігається у в’язці ключів пристрою, окремо для кожного провайдера, і на тому самому екрані застосунок пише, що він «надсилається лише» до вибраного провайдера. Запит є multipart з file, model, response_format: json і, якщо ви не лишили автовизначення, language.
Обидва варіанти існують, бо розв’язують різні задачі. Локальний Whisper приватний, працює без зв’язку і нічого не коштує за диктовку, натомість займає місце й пам’ять і залежить від потужності телефона. Хмара нічого не займає на телефоні й дає великі моделі, які на нього не вмістяться, але аудіо виходить з пристрою, потрібне з’єднання, і ви платите провайдерові. Groq запускає ту саму large-v3-turbo, яку Wendo пропонує локально, тільки на своїх серверах, а не на вашому телефоні. OpenAI додає власні моделі розпізнавання.
Наша порада: почніть з локальної base і кількох замін. Якщо ви диктуєте багато, телефон ледве тягне великі моделі, а те, що аудіо виходить з пристрою, вас не турбує, переходьте на BYOK.
Спробувати
Диктування є частиною Wendo, якого ще немає в магазинах застосунків. Вмикається воно мікрофоном на панелі термінала чи редактора або довгим натисканням кнопки клавіатури, це жест за замовчуванням. Якщо комп’ютер ще не налаштований для розмови з агентом з телефона, почніть зі статті як користуватися Claude Code з телефона, а щоб сесія жила, поки ви диктуєте, прочитайте мінімальний tmux для кодингових агентів.