 Lirafy
인터넷 없이 폰에서 Whisper 쓰기: Wendo의 받아쓰기 방식
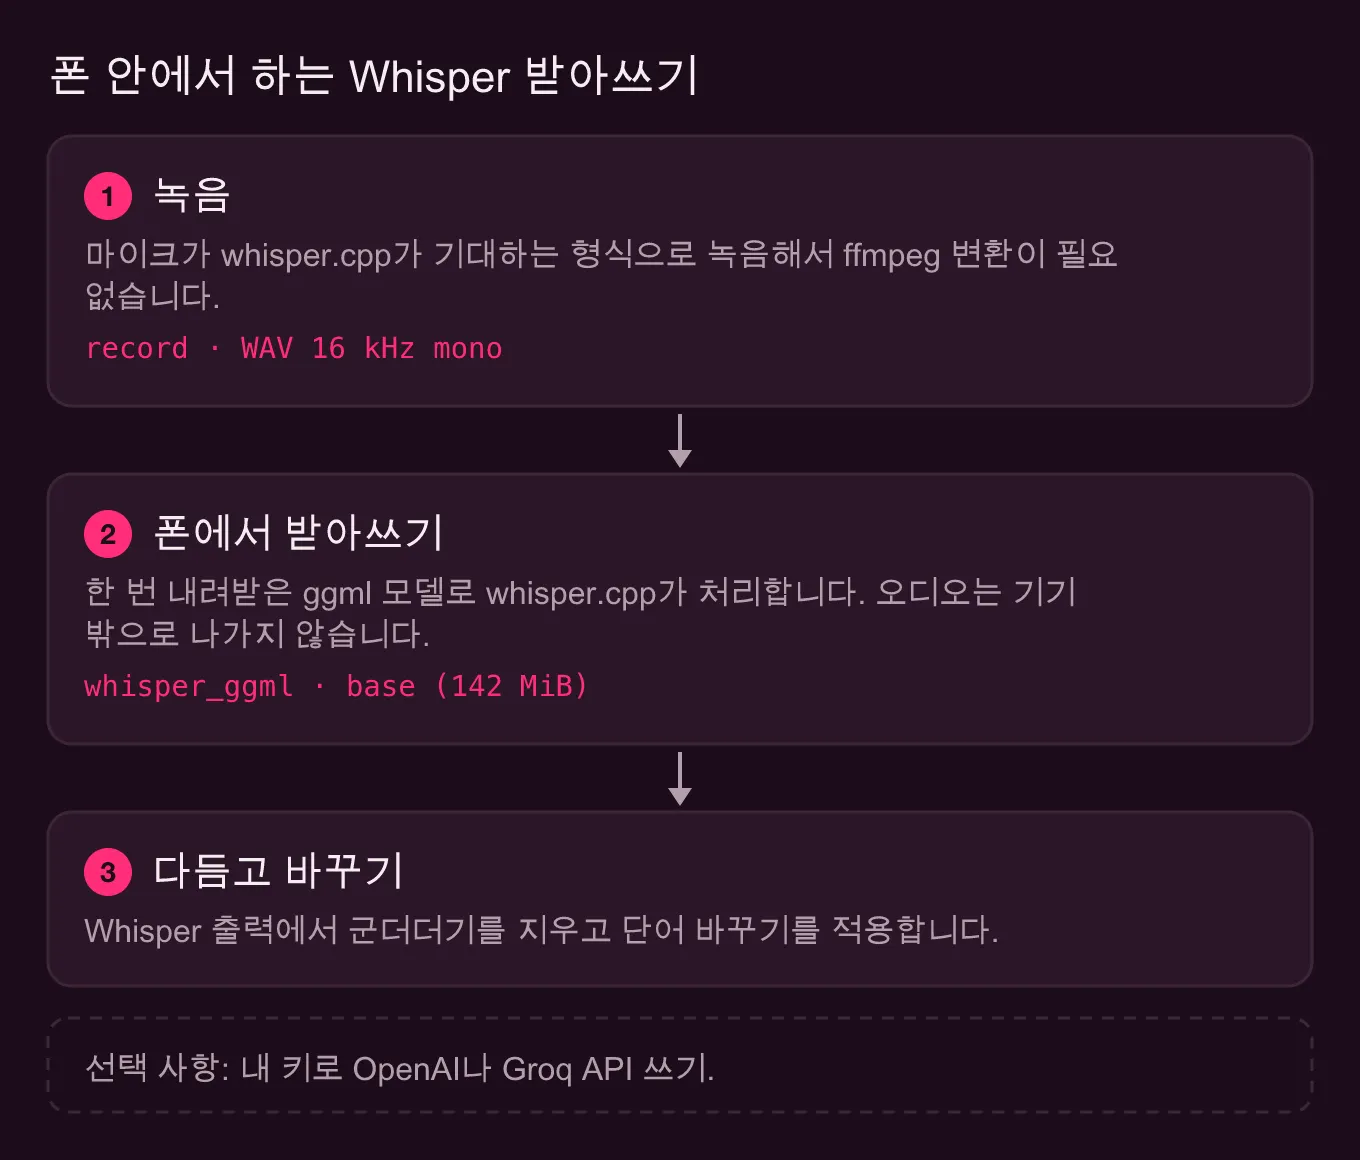
네, Whisper는 인터넷 없이 폰에서 돌아갑니다. whisper.cpp와 한 번만 내려받는 ggml 모델이 있으면 폰이 스스로 음성을 글로 바꾸고, 오디오는 기기 밖으로 나가지 않습니다. Wendo의 받아쓰기가 이렇게 동작합니다. Wendo는 Claude Code 같은 에이전트를 iOS와 Android에서 따라가기 위해 저희가 만든 SSH 클라이언트입니다. 어떤 모델을 제공하는지, 모델을 어떻게 내려받는지, 어떤 형식으로 녹음하는지, Whisper가 돌려준 결과를 어떻게 다듬는지, 그리고 내 키로 OpenAI나 Groq API를 쓰는 선택지를 왜 함께 두었는지 정리했습니다.
Whisper를 폰에서 인터넷 없이 쓰는 이유
폰 키보드로 코딩 에이전트에게 지시를 쓰는 일은 느립니다. Claude Code에 주는 지시는 대개 긴 문장이고(“로그인 테스트가 왜 실패하는지 보고, 마이그레이션은 건드리지 마”), 이걸 엄지로 치는 게 가장 귀찮은 부분입니다. 말로 하는 편이 빠릅니다.
문제는 말하는 내용입니다. 에이전트에게 받아쓰게 할 때는 파일 이름, 경로, 브랜치, 때로는 고객과 관련된 것까지 입에 올립니다. 그 오디오를 글로 바꾸려고 남의 서버에 보내는 게 늘 내키지는 않고, 신호가 약하면 아예 동작하지도 않습니다. 그래서 Wendo의 기본 엔진은 로컬 Whisper입니다. lib/core/settings.dart의 초깃값은 speechEngine = 'whisper'이고 모델은 base이며, 설정 화면은 이를 한 줄로 설명합니다. “Whisper는 whisper.cpp로 휴대폰에서 받아쓰기를 처리하며, 오디오는 어떤 서버로도 전송되지 않습니다.”
Flutter에서 whisper.cpp 쓰기: whisper_ggml과 record
whisper.cpp는 OpenAI의 음성 인식 모델인 Whisper를 C/C++로 다시 구현한 것으로, ggml 형식의 가중치를 씁니다. 무거운 의존성 없이 CPU에서 돌고, 저장소에는 iOS와 Android용 공식 예제도 있습니다. Flutter에서는 바인딩을 직접 작성할 필요가 없습니다. pub.dev에 이를 감싼 패키지가 여러 개 있습니다.
pubspec.yaml을 보면 Wendo는 두 개를 씁니다.
record: ^7.1.2
whisper_ggml: ^2.8.1record가 마이크를 녹음하고 whisper_ggml이 whisper.cpp를 호출합니다.
얼핏 봐서는 모르는 부분이 하나 있습니다. whisper_ggml은 입력 오디오를 ffmpeg로 변환하는데, 그것 하나 때문에 모바일 앱에 ffmpeg를 넣으면 큰 의존성을 떠안게 됩니다. Wendo는 이미 whisper.cpp가 기대하는 형식으로 녹음하므로, pubspec.yaml에서 그 패키지를 로컬 스텁으로 바꿔 끼웁니다.
dependency_overrides:
  # whisper_ggml convierte el audio con ffmpeg; Wendo ya graba WAV de 16 kHz mono (ver el paquete).
  ffmpeg_kit_flutter_new_min:
path: packages/ffmpeg_kit_stub스텁(packages/ffmpeg_kit_stub/lib/ffmpeg_kit.dart)은 execute만 구현하고, 이 함수는 항상 “실패”합니다. 그 실패를 받으면 whisper_ggml은 파일을 그대로 받아씁니다. 이 패키지로 Flutter에서 오프라인 Whisper를 만들고 있고 녹음을 직접 16 kHz WAV로 하고 있다면, 같은 방법으로 ffmpeg를 덜어 낼 수 있습니다.
제공하는 Whisper 모델과 용량
Wendo는 앱 안에 모델을 넣어 두지 않습니다. “설정 › 음성”에 일곱 개가 있고, lib/core/dictation.dart의 WHISPER_MODELS에 두 묶음으로 정의되어 있습니다.
- 다국어: Tiny(75 MB), Base(142 MB), Small(466 MB), 그리고
large-v3-turbo인 Turbo(앱에는 1.6 GB로 표시). - 영어 전용:
tiny.en,base.en,small.en. 용량은 다국어 버전과 같습니다.
이 용량은 whisper.cpp의 공식 모델 표(ggml-org 저장소의 models/README.md)와 일치합니다. 거기에는 75 MiB, 142 MiB, 466 MiB, 그리고 large-v3-turbo가 1.5 GiB로 나와 있습니다. Turbo의 차이는 단위 때문이고, 1.5 GiB는 약 1.6 GB입니다.
whisper.cpp의 메인 README에는 크기별 대략적인 메모리 사용량도 나와 있습니다. tiny가 약 273 MB, base가 388 MB, small이 852 MB입니다. 컴퓨터에서는 상관없습니다. SSH 세션과 터미널, 어쩌면 브라우저까지 열려 있는 폰에서는 체감이 됩니다.
폰에서 쓸 Whisper 모델 고르기
앱 안의 설명이 잘 요약해 줍니다. Tiny는 “가장 빠름, 정확도 낮음”, Base는 “빠름, 정확도 양호”, Small은 “다소 느림, 정확도 우수”, Turbo는 “최고 정확도”입니다. 에이전트에게 받아쓰게 하는 용도라면 base가 출발점으로 알맞고, 그래서 기본값으로 두었습니다.
.en 모델은 영어만 알아듣습니다. Wendo는 이를 코드에서 강제하므로, 언어 설정은 이 모델들에 영향을 주지 않습니다.
// Los modelos «.en» solo entienden inglés.
final language = whisperModel.endsWith('.en') ? 'en' : settings.whisperLanguage;
늘 영어로 말한다면 .en을 쓸 만합니다. OpenAI의 Whisper 저장소에 따르면 .en 버전이 영어에서 더 잘 동작하고, 특히 tiny와 base 크기에서 그렇습니다. 여러 언어를 섞어 쓰거나, 한국어로 말하면서 함수 이름만 영어로 말한다면 다국어 모델에 언어를 고정해서 쓰세요. 기본값은 자동 감지(auto)지만, 세 단어짜리 받아쓰기에서는 Whisper가 언어를 맞히기에 오디오가 너무 짧습니다. 언어를 고정하면 그 걱정이 사라집니다.
지연 시간은 내 폰에서 재 보기
저희는 받아쓰기 시간을 공개하지 않습니다. 폰, 모델, 말하는 길이에 따라 달라지기 때문입니다. 대신 Wendo에서 직접 잴 수 있게 했습니다. “설정 › 음성”에 엔진을 시험하는 마이크 버튼이 있고, 인식된 텍스트 아래에 엔진, 모델, 언어, 형식, 오디오 길이, 밀리초 단위 지연 시간이 한 줄로 나옵니다. 이 값은 받아쓰기마다 durationMs와 latencyMs를 저장하는 TranscriptionResult에서 옵니다. 같은 문장으로 base와 small을 시험해 보고 내 숫자로 정하세요.
모델을 내려받는 방식
모델은 Hugging Face에 있는 whisper.cpp 저장소에서 표준 파일 이름으로 가져옵니다.
const _hf = 'https://huggingface.co/ggerganov/whisper.cpp/resolve/main';
String _fileName(String id) => 'ggml-$id.bin';
아직 없는 모델을 누르면 downloadModel이 먼저 임시 폴더의 .part 파일로 내려받고, 다 받으면 앱의 문서 폴더로 옮깁니다. 두 폴더가 서로 다른 볼륨에 있어 이름을 바꿀 수 없으면 복사한 뒤 임시 파일을 지웁니다. 그래서 중간에 끊긴 다운로드가 정상 모델로 취급되는 일은 없습니다.
그래도 모델이 손상될 수는 있습니다. whisper.cpp가 “failed to load the model”을 돌려주면 Wendo는 날것의 오류를 보여 주지 않고, 모델이 손상되었다고 알린 뒤 “설정 › 음성”에서 지우고 다시 내려받으라고 안내합니다.
whisper.cpp가 기대하는 형식으로 녹음하기
whisper.cpp는 16비트 PCM, 16 kHz, 모노 WAV로 동작하고, README에는 그 형식으로 바꾸는 ffmpeg 명령까지 나와 있습니다. Wendo는 record로 처음부터 그 형식으로 녹음합니다.
const RecordConfig(
  encoder: AudioEncoder.pcm16bits,
  sampleRate: _sampleRate, // 16000
  numChannels: 1,
  androidConfig: AndroidRecordConfig(audioSource: AndroidAudioSource.voiceRecognition),
)
Android에서는 음성 인식용으로 만들어진 VOICE_RECOGNITION 소스를 요청합니다. 말하는 동안 PCM 조각이 메모리에 쌓입니다. 녹음을 멈추면 Wendo는 마지막 조각이 도착하도록 200 ms를 기다리고, 0.3초보다 짧은 녹음은 대개 실수로 누른 것이라 버립니다. 그다음 44바이트 RIFF 헤더를 앞에 붙이고(lib/components/settings/byok.dart의 encodeWav), 캐시에 dictation.wav를 쓰고, 받아쓴 뒤, 잘 됐든 안 됐든 finally에서 파일을 지웁니다.
모델은 받아쓰기 사이에도 올려 둔 채로 둡니다(keepModelLoaded: true). 그래서 모델을 불러오는 비용은 첫 번째 받아쓰기만 치릅니다. 모델을 바꾸거나 사용 중인 모델을 지우면, Wendo는 먼저 whisper 컨텍스트를 해제합니다.
Whisper가 돌려준 결과 다듬기
Whisper가 늘 받아쓴 문장만 돌려주지는 않습니다. 목소리가 들리지 않으면 [BLANK_AUDIO] 같은 표시나 “(침묵)” 같은 괄호 문구를 씁니다. 편집기에서는 거슬리지 않지만, 터미널에서는 에이전트 프롬프트에 그대로 들어갑니다. _stripNonSpeech는 대문자로 된 대괄호 부분을 지우고, 결과가 괄호나 별표뿐이면 통째로 버립니다.
다듬은 텍스트는 작성기나 터미널로 갑니다. 기본적으로 Enter 없이 입력되므로 보내기 전에 확인할 수 있고, 자동 전송을 켰을 때만 바로 보냅니다. 받아쓴 내용은 모두 로컬 기록(“설정 › 음성 › 받아쓰기 기록”)에 남고, 거기서 다시 보낼 수 있습니다.
단어 바꾸기
작은 모델은 “tmux”, “kubectl”, 내 프로젝트 이름을 거의 맞히지 못합니다. 그래서 단어 바꾸기가 있습니다. “Whisper가 알아들은 것” → “원래 말하려던 것” 쌍을 등록합니다. 구현은 몇 줄이면 됩니다.
// Reemplazos de palabras: en orden, sin distinguir mayúsculas, solo los activos.
String applyReplacements(String text) {
  var out = text;
  for (final replacement in getSettings().dictationReplacements) {
    if (!replacement.enabled || replacement.from.isEmpty) continue;
    out = out.replaceAllMapped(RegExp(RegExp.escape(replacement.from), caseSensitive: false), (_) => replacement.to);
  }
  return out;
}
바꾸기는 순서대로, 대소문자를 구분하지 않고 적용됩니다. 지우지 않고 끌 수 있고, 바꿀 말이 비어 있으면 그 단어가 사라집니다. 로컬 Whisper든 클라우드든 똑같이 동작합니다. 업무에서 쓰는 고유 명사라면 더 큰 모델로 넘어가는 것보다 바꾸기를 하나 등록하는 편이 싸게 먹힙니다.
다른 선택지: 내 키 쓰기(OpenAI 또는 Groq)
BYOK(“bring your own key”) 엔진은 같은 WAV를 내 API 키로 클라우드 제공자에게 올립니다. Wendo는 BYOK_PROVIDERS에 정의된 두 곳을 지원합니다.
- OpenAI.
/v1/audio/transcriptions로 보내고, 기본 모델은gpt-4o-mini-transcribe입니다. - Groq. OpenAI 호환 엔드포인트로 보내고, 기본값은
whisper-large-v3-turbo입니다.
모델 칸은 수정할 수 있어서, 제공자가 지원하는 다른 모델을 넣을 수 있습니다. 키는 제공자마다 하나씩 기기 키체인에 저장되고, 앱은 같은 화면에서 키가 선택한 제공자로만 전송된다고 알려 줍니다. 요청은 file, model, response_format: json, 그리고 자동 감지를 그대로 두지 않았다면 language가 들어간 multipart입니다.
두 선택지가 함께 있는 건 해결하는 문제가 다르기 때문입니다. 로컬 Whisper는 사적이고, 신호가 없어도 동작하며, 받아쓰기마다 돈이 들지 않습니다. 대신 저장 공간과 메모리를 차지하고 폰 성능에 좌우됩니다. 클라우드는 폰 공간을 차지하지 않고 폰에 들어가지 않는 큰 모델을 쓸 수 있게 해 주지만, 오디오가 기기 밖으로 나가고, 연결이 필요하고, 제공자에게 요금을 냅니다. Groq가 돌리는 모델은 Wendo가 로컬로 제공하는 것과 같은 large-v3-turbo이고, 차이는 내 폰이 아니라 Groq 서버에서 돈다는 점입니다. OpenAI는 자체 받아쓰기 모델을 제공합니다.
저희 추천은 로컬 base와 단어 바꾸기 몇 개로 시작하는 것입니다. 받아쓰기를 많이 하고, 큰 모델에서는 폰이 버거워하고, 오디오가 기기 밖으로 나가도 상관없다면 BYOK로 옮기세요.
써 보기
받아쓰기는 Wendo의 한 부분이고, Wendo는 아직 스토어에 나오지 않았습니다. 터미널이나 작성기 막대의 마이크로 켜거나, 기본 제스처인 키보드 버튼 길게 누르기로 켭니다. 폰에서 에이전트와 이야기할 수 있도록 컴퓨터를 아직 준비하지 않았다면 폰에서 Claude Code 사용하기부터 보세요. 받아쓰는 동안 세션이 살아 있게 하려면 코딩 에이전트를 위한 tmux가 도움이 됩니다.