 Lirafy
Whisper sul telefono, senza internet: come funziona la dettatura di Wendo
Sì, Whisper funziona sul telefono senza internet. Con whisper.cpp e un modello ggml scaricato una volta, il telefono trascrive la voce da solo e l’audio non lascia il dispositivo. È così che detta Wendo, il nostro client SSH per seguire agenti come Claude Code da iOS e Android. Qui raccontiamo com’è fatto: quali modelli offre, come li scarica, in che formato registra, cosa fa con quello che Whisper restituisce e perché esiste anche l’opzione di usare l’API di OpenAI o di Groq con la tua chiave.
Whisper senza internet sul telefono: perché lo usiamo
Scrivere a un agente di codice dalla tastiera del telefono è lento. Le istruzioni per Claude Code sono di solito frasi lunghe («controlla perché fallisce il test del login e non toccare la migrazione»), e batterle col pollice è proprio la parte che scoraggia. Parlare è più veloce.
Il problema è cosa dici. Quando detti a un agente nomini file, percorsi, branch e a volte cose del cliente. Mandare quell’audio al server di qualcun altro per trasformarlo in testo non sempre va bene, e con poca copertura non funziona nemmeno. Per questo il motore predefinito di Wendo è Whisper in locale. In lib/core/settings.dart il valore iniziale è speechEngine = 'whisper' con il modello base, e la schermata delle impostazioni lo riassume in una riga: «Whisper trascrive sul telefono con whisper.cpp: nessun audio viene inviato a un server».
whisper.cpp in Flutter: whisper_ggml e record
whisper.cpp è la reimplementazione in C/C++ di Whisper, il modello di riconoscimento vocale di OpenAI, e usa il formato di pesi ggml. Gira su CPU senza dipendenze pesanti e il suo repository ha esempi ufficiali per iOS e Android. In Flutter non serve scrivere i binding a mano: su pub.dev ci sono diversi pacchetti che lo incapsulano.
Wendo ne usa due, secondo il suo pubspec.yaml:
record: ^7.1.2
whisper_ggml: ^2.8.1
record registra il microfono e whisper_ggml chiama whisper.cpp.
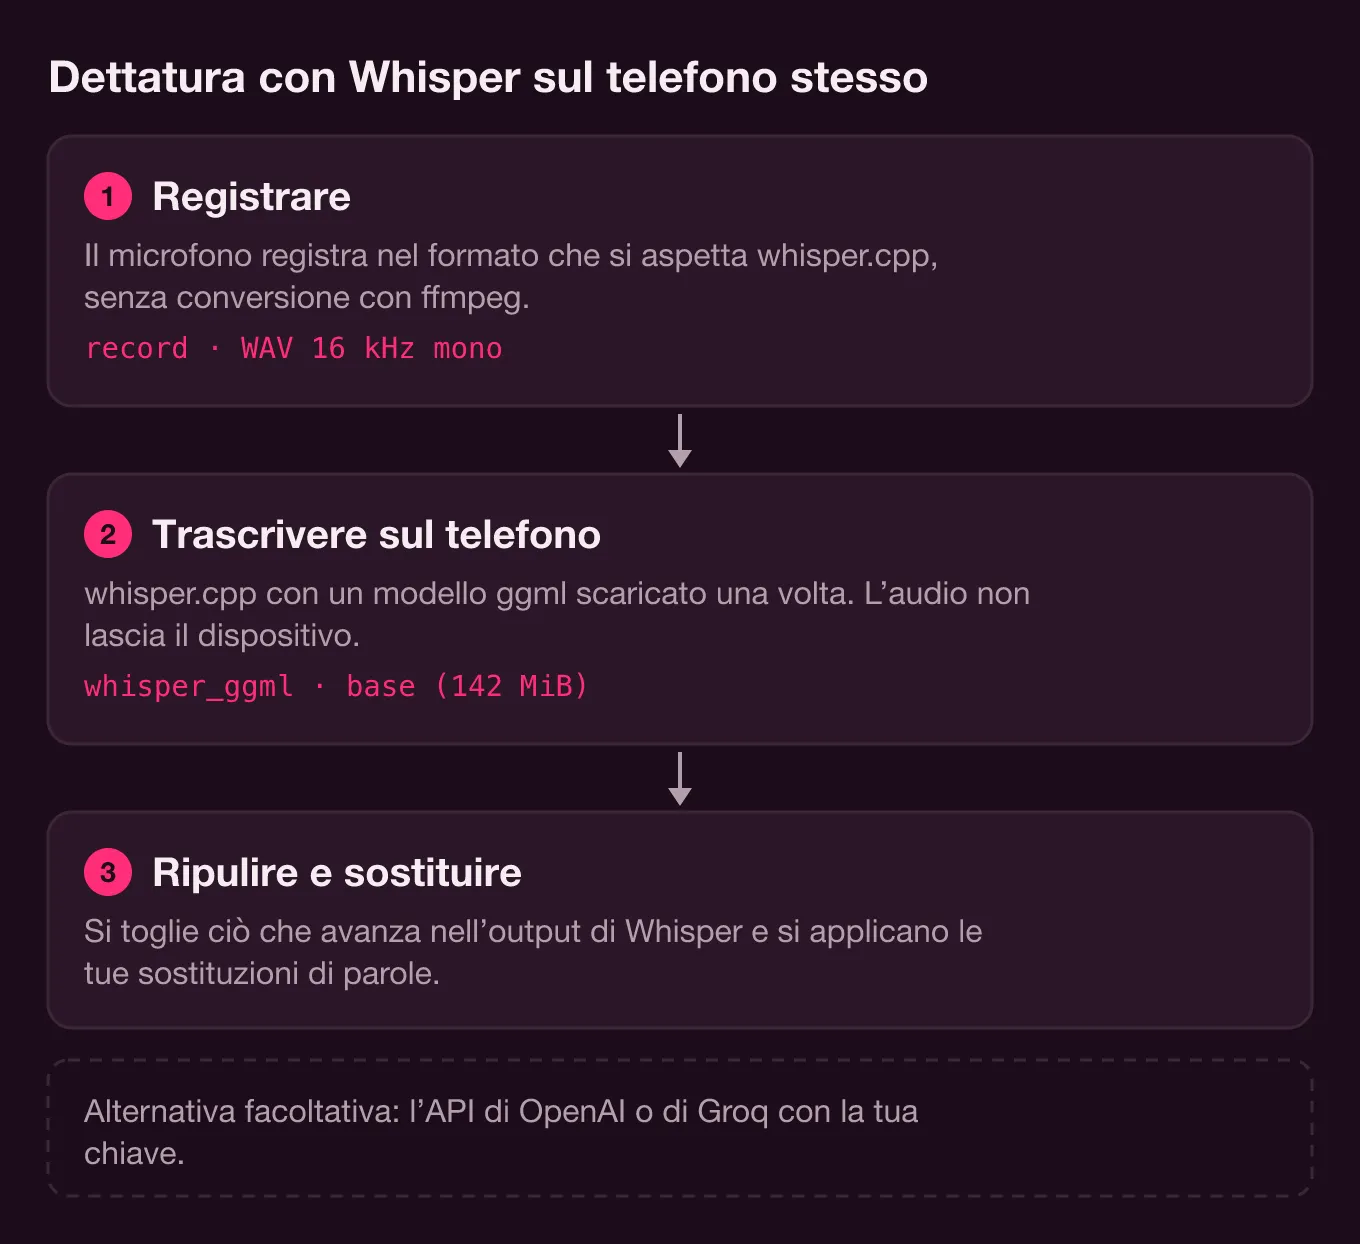
C’è un dettaglio che a prima vista sfugge. whisper_ggml converte l’audio in ingresso con ffmpeg, e mettere ffmpeg in un’app mobile solo per questo vuol dire portarsi dietro una dipendenza grossa. Siccome Wendo registra già nel formato che si aspetta whisper.cpp, il pubspec.yaml sostituisce quel pacchetto con uno stub locale:
dependency_overrides:
  # whisper_ggml converte l’audio con ffmpeg; Wendo registra già WAV a 16 kHz mono (vedi il pacchetto).
  ffmpeg_kit_flutter_new_min:
    path: packages/ffmpeg_kit_stub
Lo stub (packages/ffmpeg_kit_stub/lib/ffmpeg_kit.dart) implementa solo execute, che «fallisce» sempre. Davanti a quel fallimento, whisper_ggml trascrive il file così com’è. Se monti Whisper offline in Flutter con questo pacchetto e la registrazione in WAV a 16 kHz la fai già tu, puoi liberarti di ffmpeg nello stesso modo.
Quali modelli Whisper offre e quanto pesano
Wendo non include nessun modello nell’app. Ne offre sette in Impostazioni › Voce, definiti in WHISPER_MODELS di lib/core/dictation.dart, divisi in due gruppi:
- Multilingue: Tiny (75 MB), Base (142 MB), Small (466 MB) e Turbo, cioè
large-v3-turbo(l’app lo mostra come 1.6 GB). - Solo inglese:
tiny.en,base.enesmall.en, con le stesse dimensioni delle versioni multilingue.
Quelle dimensioni coincidono con la tabella ufficiale dei modelli di whisper.cpp (models/README.md nel repository di ggml-org), che riporta 75 MiB, 142 MiB, 466 MiB e 1,5 GiB per large-v3-turbo. La differenza del Turbo è solo di unità: 1,5 GiB sono circa 1,6 GB.
Il README principale di whisper.cpp pubblica anche la memoria approssimativa che usa ogni dimensione: circa 273 MB il tiny, 388 MB il base e 852 MB lo small. Su un computer non cambia niente. Su un telefono che ha aperti anche una sessione SSH, un terminale e magari un browser, si sente.
Quale modello di Whisper usare sul telefono
Le descrizioni dell’app lo riassumono: Tiny è «il più veloce, precisione inferiore», Base «veloce, buona precisione», Small «più lento, ottima precisione» e Turbo «massima precisione». Per dettare a un agente, base è un buon punto di partenza, ed è per questo il valore predefinito.
I modelli .en capiscono solo l’inglese. Wendo lo forza nel codice, quindi l’impostazione della lingua non li tocca:
// I modelli «.en» capiscono solo l’inglese.
final language = whisperModel.endsWith('.en') ? 'en' : settings.whisperLanguage;
Se detti sempre in inglese, conviene usarli: il repository di Whisper di OpenAI indica che le versioni .en rendono meglio in inglese, soprattutto nelle taglie tiny e base. Se mescoli lingue, o parli italiano con nomi di funzioni in inglese, usa un multilingue con la lingua fissata. Il rilevamento automatico (auto) è il valore predefinito, ma in una dettatura di tre parole Whisper ha troppo poco audio per indovinare la lingua, e fissarla ti toglie il dubbio.
Misura la latenza sul tuo telefono
Non pubblichiamo tempi di trascrizione perché dipendono dal telefono, dal modello e da quanto parli. Wendo invece ti lascia misurarli. In Impostazioni › Voce c’è un pulsante del microfono per provare il motore, e sotto il testo riconosciuto compare una riga con motore, modello, lingua, formato, durata dell’audio e latenza in millisecondi. Viene da TranscriptionResult, che salva durationMs e latencyMs per ogni trascrizione. Prova base e small con la stessa frase e decidi con i tuoi numeri.
Come si scarica un modello
I modelli arrivano dal repository di whisper.cpp su Hugging Face, con il nome di file standard:
const _hf = 'https://huggingface.co/ggerganov/whisper.cpp/resolve/main';
String _fileName(String id) => 'ggml-$id.bin';
Quando tocchi un modello che non hai, downloadModel lo scarica prima in un file .part nella cartella temporanea e, a download finito, lo sposta nella cartella documenti dell’app. Se le due cartelle stanno su volumi diversi e non si può rinominare, lo copia e cancella il temporaneo. Così un download interrotto non passa mai per un modello valido.
Un modello può comunque finire danneggiato. Quando whisper.cpp risponde «failed to load the model», Wendo non mostra l’errore crudo: ti avvisa che il modello è danneggiato e ti chiede di eliminarlo in Impostazioni › Voce e scaricarlo di nuovo.
Registrare nel formato che si aspetta whisper.cpp
whisper.cpp lavora con WAV PCM a 16 bit, 16 kHz e mono; il suo README riporta perfino il comando ffmpeg per convertire in quel formato. Wendo registra direttamente così, con record:
const RecordConfig(
  encoder: AudioEncoder.pcm16bits,
  sampleRate: _sampleRate, // 16000
  numChannels: 1,
  androidConfig: AndroidRecordConfig(audioSource: AndroidAudioSource.voiceRecognition),
)
Su Android chiede la sorgente VOICE_RECOGNITION, pensata per il riconoscimento vocale. I pezzi di PCM si accumulano in memoria mentre parli. Quando ti fermi, Wendo aspetta 200 ms che arrivi l’ultimo pezzo e scarta le registrazioni sotto 0,3 secondi, che di solito sono tocchi involontari. Poi antepone un header RIFF di 44 byte (encodeWav in lib/components/settings/byok.dart), scrive dictation.wav nella cache, trascrive e cancella il file in un finally, che sia andata bene o male.
Il modello resta caricato tra una dettatura e l’altra (keepModelLoaded: true), così solo la prima paga il costo del caricamento. Se cambi modello o elimini quello in uso, Wendo prima libera il contesto di whisper.
Ripulire quello che restituisce Whisper
Whisper non restituisce sempre testo dettato. Quando non sente voce, scrive marcatori come [BLANK_AUDIO] o frasi tra parentesi del tipo «(silenzio)». In un editor non danno fastidio; in un terminale finiscono nel prompt dell’agente. _stripNonSpeech toglie quello che sta tra parentesi quadre in maiuscolo e scarta tutto il risultato se è solo una parentesi o degli asterischi.
Il testo pulito va all’editor o al terminale. Di default viene scritto senza premere Invio, così lo rivedi prima di mandarlo, a meno che tu non attivi Invio automatico. Ogni dettatura resta in una cronologia locale (in Impostazioni › Voce › Cronologia dettature) da cui puoi rimandarla.
Sostituzioni di parole
Nessun modello piccolo azzecca «tmux», «kubectl» o il nome del tuo progetto. Per questo ci sono le sostituzioni di parole: coppie «quello che capisce Whisper» → «quello che volevi dire». L’implementazione sta in poche righe:
// Sostituzioni di parole: in ordine, senza distinguere maiuscole, solo quelle attive.
String applyReplacements(String text) {
  var out = text;
  for (final replacement in getSettings().dictationReplacements) {
    if (!replacement.enabled || replacement.from.isEmpty) continue;
    out = out.replaceAllMapped(RegExp(RegExp.escape(replacement.from), caseSensitive: false), (_) => replacement.to);
  }
  return out;
}
Si applicano in ordine e senza distinguere maiuscole e minuscole, si possono disattivare senza cancellarle e, se la destinazione è vuota, la parola viene eliminata. Funzionano allo stesso modo con Whisper locale e con il cloud. Per i nomi propri del tuo lavoro, una sostituzione costa meno che passare a un modello più grande.
L’alternativa: usa la tua chiave (OpenAI o Groq)
Il motore BYOK («bring your own key») carica lo stesso WAV su un provider cloud con la tua chiave API. Wendo ne supporta due, definiti in BYOK_PROVIDERS:
- OpenAI, su
/v1/audio/transcriptions, congpt-4o-mini-transcribecome modello predefinito. - Groq, sul suo endpoint compatibile con OpenAI, con
whisper-large-v3-turbocome predefinito.
Il campo del modello è modificabile, quindi puoi metterne un altro supportato dal tuo provider. La chiave viene salvata nel portachiavi del dispositivo, una per provider, e la schermata stessa dice che viene «inviata solo» al provider scelto. La richiesta è un multipart con file, model, response_format: json e, se non hai lasciato il rilevamento automatico, language.
Le due opzioni esistono perché risolvono cose diverse. Whisper locale è privato, funziona senza copertura e non costa niente a dettatura, ma occupa spazio e memoria e dipende dalla potenza del telefono. Il cloud non occupa niente sul telefono e ti dà modelli grandi che lì non entrano, però l’audio esce dal dispositivo, ti serve la connessione e paghi il provider. Groq serve lo stesso large-v3-turbo che Wendo offre in locale, con la differenza che lo esegue sui suoi server e non sul tuo telefono. OpenAI aggiunge i suoi modelli di trascrizione.
Il nostro consiglio: parti da base in locale e qualche sostituzione. Se detti molto, il telefono fatica con i modelli grandi e non ti importa che l’audio esca dal dispositivo, passa a BYOK.
Provarlo
La dettatura è una parte di Wendo, che non è ancora negli store. Si attiva con il microfono della barra del terminale o dell’editor, oppure tenendo premuto il pulsante della tastiera, che è il gesto predefinito. Se non hai ancora preparato il computer per parlare con un agente dal telefono, comincia da come usare Claude Code dal telefono, e per tenere viva la sessione mentre detti, il tmux minimo per agenti di codice.