 Lirafy
Whisper no celular, sem internet: como o Wendo faz ditado
Sim, o Whisper funciona no celular sem internet. Com o whisper.cpp e um modelo ggml baixado uma vez, o aparelho transcreve a voz sozinho e o áudio não sai dele. É assim que o Wendo faz ditado: ele é o nosso cliente SSH para acompanhar agentes como o Claude Code pelo iOS e pelo Android.
Aqui contamos como isso foi feito: que modelos ele oferece, como baixa cada um, em que formato grava, o que faz com o que o Whisper devolve e por que também existe a opção de usar a API da OpenAI ou da Groq com a sua própria chave.
Whisper offline no celular: por que usamos
Escrever para um agente de código pelo teclado do celular é lento. As instruções para o Claude Code costumam ser frases longas (“veja por que o teste de login está falhando e não mexa na migração”), e digitar isso com o polegar é justamente a parte que dá preguiça. Falar é mais rápido.
O problema é o que você fala. Ao ditar para um agente, você cita arquivos, caminhos, branches e às vezes coisas do cliente. Mandar esse áudio para o servidor de outra empresa para virar texto nem sempre é uma boa ideia, e com sinal ruim nem funciona. Por isso o motor padrão do Wendo é o Whisper local. Em lib/core/settings.dart o valor inicial é speechEngine = 'whisper' com o modelo base, e a tela de ajustes resume isso numa linha: “O Whisper transcreve no celular com whisper.cpp: nenhum áudio é enviado a nenhum servidor”.
Como usar o whisper.cpp no Flutter: whisper_ggml e record
O whisper.cpp é a reimplementação em C/C++ do Whisper, o modelo de reconhecimento de voz da OpenAI, e usa o formato de pesos ggml. Ele roda na CPU sem dependências pesadas, e o repositório traz exemplos oficiais para iOS e Android. No Flutter não é preciso escrever os bindings à mão: há vários pacotes no pub.dev que o encapsulam.
O Wendo usa dois, segundo o pubspec.yaml:
record: ^7.1.2
whisper_ggml: ^2.8.1
O record grava o microfone e o whisper_ggml chama o whisper.cpp.
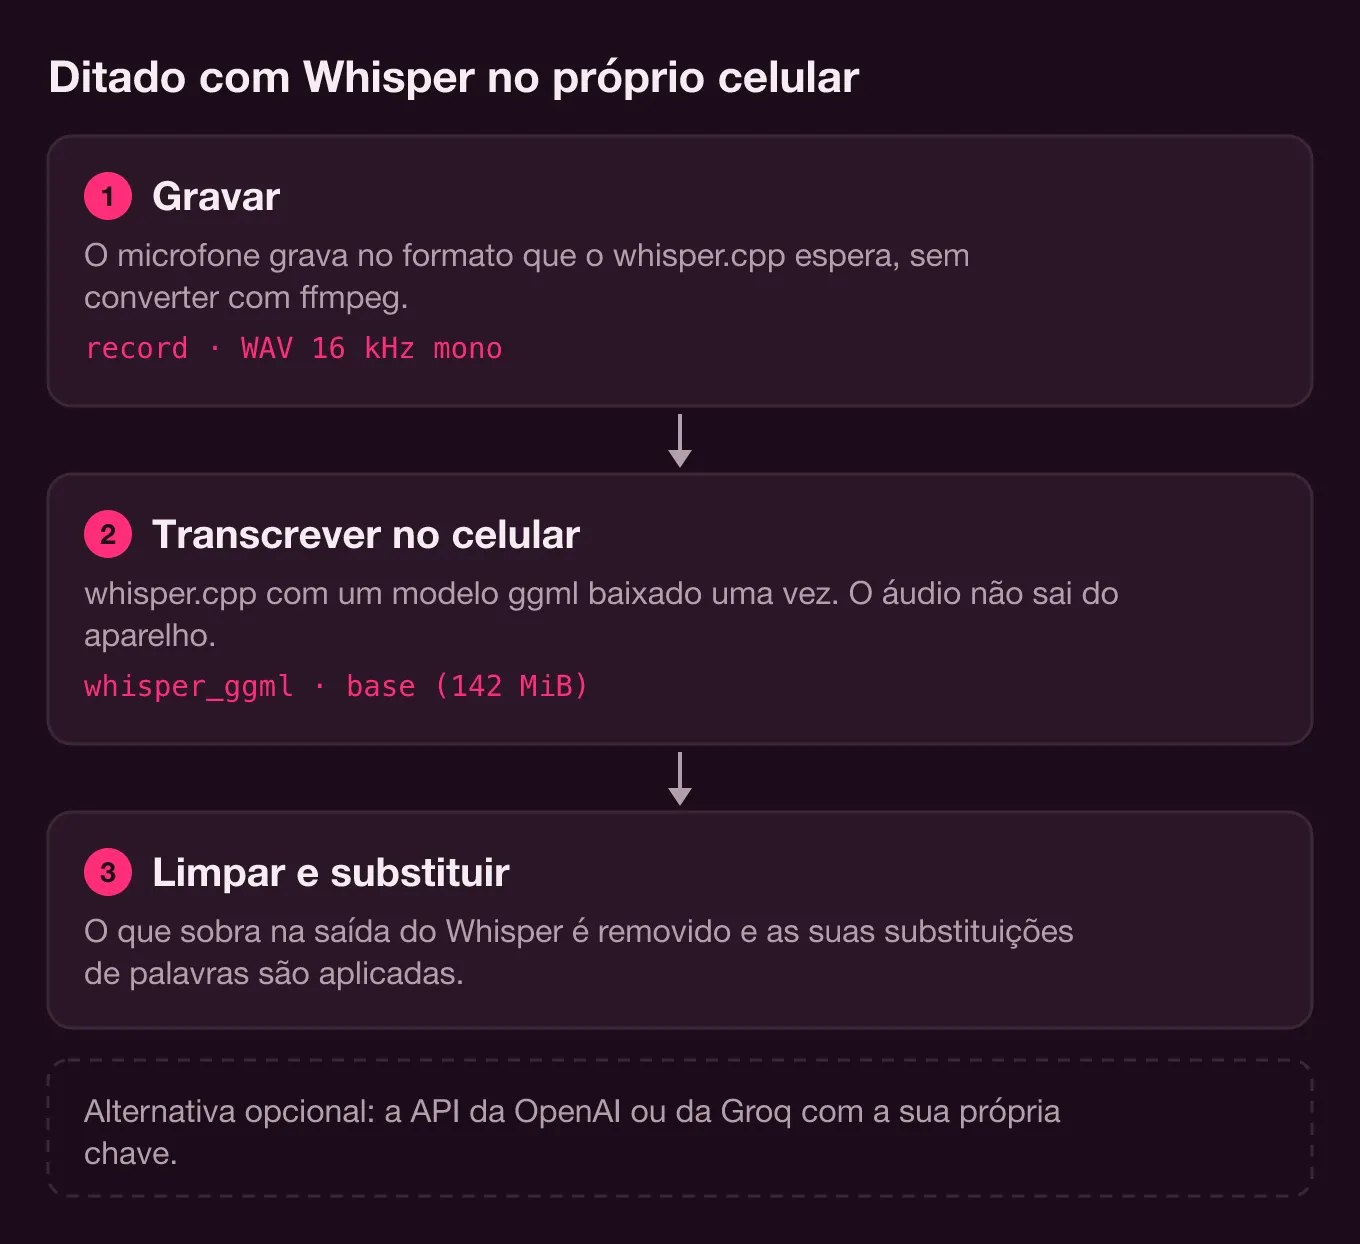
Tem um detalhe que não aparece de cara. O whisper_ggml converte o áudio de entrada com ffmpeg, e colocar ffmpeg num app mobile só para isso é carregar uma dependência grande. Como o Wendo já grava no formato que o whisper.cpp espera, o pubspec.yaml troca esse pacote por um stub local:
dependency_overrides:
  # O whisper_ggml converte o áudio com ffmpeg; o Wendo já grava WAV de 16 kHz mono (veja o pacote).
  ffmpeg_kit_flutter_new_min:
    path: packages/ffmpeg_kit_stub
O stub (packages/ffmpeg_kit_stub/lib/ffmpeg_kit.dart) implementa só o execute, que sempre “falha”. Diante dessa falha, o whisper_ggml transcreve o arquivo como está. Se você monta Whisper offline no Flutter com esse pacote e já grava em WAV de 16 kHz por conta própria, dá para se livrar do ffmpeg do mesmo jeito.
Quais modelos do Whisper ele oferece e quanto ocupa um modelo
O Wendo não traz nenhum modelo dentro do app. Ele oferece sete em Ajustes › Fala, definidos em WHISPER_MODELS de lib/core/dictation.dart, em dois grupos:
- Multilíngues: Tiny (75 MB), Base (142 MB), Small (466 MB) e Turbo, que é o
large-v3-turbo(o app mostra como 1.6 GB). - Só inglês:
tiny.en,base.enesmall.en, com os mesmos tamanhos das versões multilíngues.
Esses tamanhos batem com a tabela oficial de modelos do whisper.cpp (models/README.md no repositório da ggml-org), que traz 75 MiB, 142 MiB, 466 MiB e 1,5 GiB para o large-v3-turbo. A diferença do Turbo é só de unidade: 1,5 GiB dá uns 1,6 GB.
O README principal do whisper.cpp também publica a memória aproximada que cada tamanho usa: uns 273 MB o tiny, 388 MB o base e 852 MB o small. Num computador tanto faz. Num celular que também está com uma sessão SSH, um terminal e talvez um navegador abertos, isso pesa.
Qual modelo do Whisper usar no celular
As descrições do próprio app resumem: Tiny é “mais rápido, menos preciso”, Base é “rápido, boa precisão”, Small é “mais lento, ótima precisão” e Turbo, “máxima precisão”. Para ditar para um agente, o base é um bom ponto de partida, e por isso é o padrão.
Os modelos .en só entendem inglês. O Wendo força isso no código, então o ajuste de idioma não os afeta:
// Os modelos “.en” só entendem inglês.
final language = whisperModel.endsWith('.en') ? 'en' : settings.whisperLanguage;
Se você dita sempre em inglês, eles compensam: o repositório do Whisper da OpenAI indica que as versões .en rendem melhor em inglês, principalmente nos tamanhos tiny e base. Se você mistura idiomas, ou fala português com nomes de funções em inglês, use um multilíngue com o idioma fixo. A detecção automática (auto) é o padrão, mas num ditado de três palavras o Whisper tem pouquíssimo áudio para adivinhar o idioma, e fixar o idioma tira essa dúvida.
Meça a latência no seu celular
Não publicamos tempos de transcrição porque eles dependem do celular, do modelo e de quanto tempo você fala. O que o Wendo faz é deixar você medir. Em Ajustes › Fala há um botão de microfone para testar o motor, e embaixo do texto reconhecido aparece uma linha com o motor, o modelo, o idioma, o formato, a duração do áudio e a latência em milissegundos. Ela vem do TranscriptionResult, que guarda durationMs e latencyMs em cada transcrição. Teste base e small com a mesma frase e decida com os seus números.
Como um modelo é baixado
Os modelos saem do repositório do whisper.cpp no Hugging Face, com o nome de arquivo padrão:
const _hf = 'https://huggingface.co/ggerganov/whisper.cpp/resolve/main';
String _fileName(String id) => 'ggml-$id.bin';
Quando você toca num modelo que não tem, o downloadModel baixa primeiro para um arquivo .part na pasta temporária e, quando termina, move para a pasta de documentos do app. Se as duas pastas estão em volumes diferentes e não dá para renomear, ele copia e apaga o temporário. Assim um download interrompido nunca se passa por modelo válido.
Mesmo assim, um modelo pode acabar corrompido. Quando o whisper.cpp responde “failed to load the model”, o Wendo não mostra o erro cru: avisa que o modelo está corrompido e pede que você o apague em Ajustes › Fala e baixe de novo.
Gravar no formato que o whisper.cpp espera
O whisper.cpp trabalha com WAV PCM de 16 bits a 16 kHz e mono; o README dele traz até o comando do ffmpeg para converter para esse formato. O Wendo já grava assim, com o record:
const RecordConfig(
  encoder: AudioEncoder.pcm16bits,
  sampleRate: _sampleRate, // 16000
  numChannels: 1,
  androidConfig: AndroidRecordConfig(audioSource: AndroidAudioSource.voiceRecognition),
)
No Android ele pede a fonte VOICE_RECOGNITION, pensada para reconhecimento de voz. Os pedaços de PCM se acumulam na memória enquanto você fala. Quando você para, o Wendo espera 200 ms pelo último pedaço e descarta gravações de menos de 0,3 segundo, que costumam ser toques sem querer. Depois coloca na frente um cabeçalho RIFF de 44 bytes (encodeWav em lib/components/settings/byok.dart), grava dictation.wav no cache, transcreve e apaga o arquivo num finally, tenha dado certo ou não.
O modelo fica carregado entre um ditado e outro (keepModelLoaded: true), então só o primeiro paga o custo de carregar. Se você troca de modelo ou apaga o que está em uso, o Wendo libera antes o contexto do whisper.
Limpar o que o Whisper devolve
O Whisper nem sempre devolve texto ditado. Quando não ouve voz, ele escreve marcações como [BLANK_AUDIO] ou frases entre parênteses do tipo “(silêncio)”. Num editor de texto isso não incomoda; num terminal vai parar no prompt do agente. O _stripNonSpeech remove o que está entre colchetes em maiúsculas e descarta o resultado inteiro se ele for só um parêntese ou asteriscos.
O texto limpo vai para o Editor ou para o terminal. Por padrão ele é escrito sem apertar Enter, para você revisar antes de mandar, a não ser que ative o Envio automático. Cada ditado fica num histórico local (em Ajustes › Fala › Histórico de ditado), de onde você pode reenviá-lo.
Substituições de palavras
Nenhum modelo pequeno acerta “tmux”, “kubectl” ou o nome do seu projeto. Para isso existem as substituições de palavras: pares “o que o Whisper entende” → “o que você quis dizer”. A implementação cabe em poucas linhas:
// Substituições de palavras: em ordem, sem diferenciar maiúsculas, só as ativas.
String applyReplacements(String text) {
  var out = text;
  for (final replacement in getSettings().dictationReplacements) {
    if (!replacement.enabled || replacement.from.isEmpty) continue;
    out = out.replaceAllMapped(RegExp(RegExp.escape(replacement.from), caseSensitive: false), (_) => replacement.to);
  }
  return out;
}
Elas são aplicadas em ordem e sem diferenciar maiúsculas de minúsculas, podem ser desativadas sem apagar e, se o destino estiver vazio, a palavra é removida. Funcionam igual com o Whisper local e com a nuvem. Para os nomes próprios do seu trabalho, uma substituição sai mais barata do que passar para um modelo maior.
A alternativa: traga sua própria chave (OpenAI ou Groq)
O motor BYOK (“bring your own key”) envia o mesmo WAV para um provedor na nuvem com a sua chave de API. O Wendo aceita dois, definidos em BYOK_PROVIDERS:
- OpenAI, no
/v1/audio/transcriptions, comgpt-4o-mini-transcribecomo modelo padrão. - Groq, no endpoint compatível com a OpenAI, com
whisper-large-v3-turbocomo padrão.
O campo do modelo é editável, então dá para colocar outro que o seu provedor aceite. A chave fica guardada nas Chaves do dispositivo, uma por provedor, e o app diz na mesma tela que ela “só é enviada” para o provedor escolhido. A requisição é um multipart com file, model, response_format: json e, se você não deixou a detecção automática, language.
As duas opções existem porque resolvem coisas diferentes. O Whisper local é privado, funciona sem sinal e não custa nada por ditado, em troca de ocupar espaço e memória e de depender da potência do celular. A nuvem não ocupa nada no celular e dá acesso a modelos grandes que não cabem nele, mas o áudio sai do aparelho, você precisa de conexão e paga o provedor. A Groq serve o mesmo large-v3-turbo que o Wendo oferece localmente, com a diferença de que roda nos servidores dela e não no seu celular. Já a OpenAI acrescenta os modelos de transcrição próprios.
Nossa recomendação: comece com o base local e algumas substituições. Se você dita muito, o celular sofre com os modelos grandes e não se importa que o áudio saia do aparelho, passe para o BYOK.
Testar
O ditado é uma parte do Wendo, que ainda não está nas lojas. Ele é ativado pelo microfone da barra do terminal ou do Editor, ou segurando o botão do teclado, que é o gesto padrão. Se você ainda não preparou o computador para falar com um agente pelo celular, comece por como usar o Claude Code pelo celular, e para manter a sessão viva enquanto dita, o tmux mínimo para agentes de código.